
当期目录
2026年 第52卷 第10期
2026, 52(10): 2152-2183.
doi: 10.16383/j.aas.c260083
cstr: 32138.14.j.aas.c260083
摘要:
自动驾驶作为具身智能的关键应用方向, 正经历从模块化结构向端到端框架的深刻变革, 而大模型的爆发为其从“感知智能”向“认知智能”的跃迁提供了关键驱动力. 首先回顾自动驾驶技术的演进历程, 剖析传统模块化结构的局限与端到端范式的兴起, 指出现有的基于监督学习的端到端模型在可解释性与因果推理上的不足. 接着引出大模型尤其是多模态大语言模型赋能自动驾驶的前沿机制, 系统梳理大语言模型、视觉−语言模型、视觉−语言−动作模型的贡献. 与此同时, 也梳理了新兴世界模型的发展脉络及其为自动驾驶带来的环境推演能力. 进一步地, 探讨自动驾驶的训练范式与验证体系变革, 分析数据集从几何感知向认知理解的演变, 以及开环评估与闭环验证的方法. 最后, 总结当前技术面临的挑战, 并展望构建数据驱动、认知增强与虚实闭环的一体化自动驾驶系统的未来方向.
自动驾驶作为具身智能的关键应用方向, 正经历从模块化结构向端到端框架的深刻变革, 而大模型的爆发为其从“感知智能”向“认知智能”的跃迁提供了关键驱动力. 首先回顾自动驾驶技术的演进历程, 剖析传统模块化结构的局限与端到端范式的兴起, 指出现有的基于监督学习的端到端模型在可解释性与因果推理上的不足. 接着引出大模型尤其是多模态大语言模型赋能自动驾驶的前沿机制, 系统梳理大语言模型、视觉−语言模型、视觉−语言−动作模型的贡献. 与此同时, 也梳理了新兴世界模型的发展脉络及其为自动驾驶带来的环境推演能力. 进一步地, 探讨自动驾驶的训练范式与验证体系变革, 分析数据集从几何感知向认知理解的演变, 以及开环评估与闭环验证的方法. 最后, 总结当前技术面临的挑战, 并展望构建数据驱动、认知增强与虚实闭环的一体化自动驾驶系统的未来方向.


2026, 52(10): 2184-2199.
doi: 10.16383/j.aas.c260096
cstr: 32138.14.j.aas.c260096
摘要:
具身学习通过智能体与环境的主动交互与数据采集, 结合模型迭代更新, 实现自主智能. 然而, 随着环境复杂度和任务规模增加, 传统单智能体方法面临数据采集效率低、样本利用效率低、训练效率低等瓶颈, 严重制约了系统可扩展性. 针对上述问题, 提出一种云边协同的多智能体具身学习框架, 充分利用视觉−语言模型的高级推理能力, 在无需额外训练的前提下实现多智能体高效在线探索与协同数据采集. 具体地, 各智能体通过视觉−语言模型对观测数据及感知信息进行解析, 构建融合语义与空间状态的好奇心地图, 以指导短期目标选择, 实现语义驱动的高价值区域利用与空间驱动的未知区域探索的协同推进; 在短期探索任务完成后, 智能体能够基于全局空间状态与共享语义信息开展长期探索规划, 以保障探索的全面性与战略性. 所有智能体完成全场景探索后, 边缘端利用采集数据进行本地模型训练, 并将更新的参数和少量数据上传至云端, 由云端进行多源知识聚合, 生成全局优化模型. 实验结果表明, 所提方法显著优于基线方法, 为大规模复杂环境下多机器人自主智能学习提供新的有效范式.
具身学习通过智能体与环境的主动交互与数据采集, 结合模型迭代更新, 实现自主智能. 然而, 随着环境复杂度和任务规模增加, 传统单智能体方法面临数据采集效率低、样本利用效率低、训练效率低等瓶颈, 严重制约了系统可扩展性. 针对上述问题, 提出一种云边协同的多智能体具身学习框架, 充分利用视觉−语言模型的高级推理能力, 在无需额外训练的前提下实现多智能体高效在线探索与协同数据采集. 具体地, 各智能体通过视觉−语言模型对观测数据及感知信息进行解析, 构建融合语义与空间状态的好奇心地图, 以指导短期目标选择, 实现语义驱动的高价值区域利用与空间驱动的未知区域探索的协同推进; 在短期探索任务完成后, 智能体能够基于全局空间状态与共享语义信息开展长期探索规划, 以保障探索的全面性与战略性. 所有智能体完成全场景探索后, 边缘端利用采集数据进行本地模型训练, 并将更新的参数和少量数据上传至云端, 由云端进行多源知识聚合, 生成全局优化模型. 实验结果表明, 所提方法显著优于基线方法, 为大规模复杂环境下多机器人自主智能学习提供新的有效范式.


2026, 52(10): 2200-2214.
doi: 10.16383/j.aas.c250754
cstr: 32138.14.j.aas.c250754
摘要:
针对多无人机在多约束下的协同任务分配问题, 提出一种面向多无人机协同任务分配的多策略融合海鸥优化算法(MFSOA). 该算法由时间代价、能耗代价、负载均衡、任务时序及多约束条件构建多无人机协同任务分配目标优化模型. 为提升算法寻优效率, 采用Tent混沌映射增强种群多样性, 结合精英进化策略优化迭代过程中的种群质量; 通过设计多方向自适应迁徙策略增强算法全局寻优能力, 避免算法陷入局部最优; 构建基于精英个体的攻击策略以平衡算法的全局探索与局部开发能力, 提升算法的寻优稳定性. 实验结果表明, MFSOA在多场景下均表现出优异的综合性能, 其寻优能力相较对比算法提升约3% ~ 13%, 验证了该算法求解多无人机协同任务分配问题的有效性与可靠性.
针对多无人机在多约束下的协同任务分配问题, 提出一种面向多无人机协同任务分配的多策略融合海鸥优化算法(MFSOA). 该算法由时间代价、能耗代价、负载均衡、任务时序及多约束条件构建多无人机协同任务分配目标优化模型. 为提升算法寻优效率, 采用Tent混沌映射增强种群多样性, 结合精英进化策略优化迭代过程中的种群质量; 通过设计多方向自适应迁徙策略增强算法全局寻优能力, 避免算法陷入局部最优; 构建基于精英个体的攻击策略以平衡算法的全局探索与局部开发能力, 提升算法的寻优稳定性. 实验结果表明, MFSOA在多场景下均表现出优异的综合性能, 其寻优能力相较对比算法提升约3% ~ 13%, 验证了该算法求解多无人机协同任务分配问题的有效性与可靠性.


2026, 52(10): 2215-2225.
doi: 10.16383/j.aas.c260048
cstr: 32138.14.j.aas.c260048
摘要:
本文研究大规模变频空调集群参与需求响应中的最优功率调度问题. 针对现有研究侧重运行经济性最优, 忽略了用户舒适需求、快速动态响应能力及用户满意度等关键工程因素的不足, 构建兼顾舒适约束与动态性能的优化调度框架. 为刻画用户舒适需求, 基于实时室内温度、设定温度及可容许温度偏差构建统一的用户舒适指标, 实现舒适水平的定量表征. 基于此, 提出一种预定义时间分布式最优功率调度策略, 通过协调各变频空调单元功率消耗, 确保在满足用户舒适约束的前提下, 集群的总功率在预定义时间内精确跟踪需求功率并实现用户满意度最优. 进一步, 将该方法扩展至阶跃需求情形, 以增强对动态需求目标的适应能力. 最后, 基于李雅普诺夫理论证明了系统的收敛性, 数值仿真验证了所提方法的有效性与工程可行性.
本文研究大规模变频空调集群参与需求响应中的最优功率调度问题. 针对现有研究侧重运行经济性最优, 忽略了用户舒适需求、快速动态响应能力及用户满意度等关键工程因素的不足, 构建兼顾舒适约束与动态性能的优化调度框架. 为刻画用户舒适需求, 基于实时室内温度、设定温度及可容许温度偏差构建统一的用户舒适指标, 实现舒适水平的定量表征. 基于此, 提出一种预定义时间分布式最优功率调度策略, 通过协调各变频空调单元功率消耗, 确保在满足用户舒适约束的前提下, 集群的总功率在预定义时间内精确跟踪需求功率并实现用户满意度最优. 进一步, 将该方法扩展至阶跃需求情形, 以增强对动态需求目标的适应能力. 最后, 基于李雅普诺夫理论证明了系统的收敛性, 数值仿真验证了所提方法的有效性与工程可行性.


2026, 52(10): 2226-2240.
doi: 10.16383/j.aas.c260053
cstr: 32138.14.j.aas.c260053
摘要:
针对一类带有全局耦合等式约束的分布式非合作博弈问题, 提出一种适用于二阶多智能体系统的预设时间分布式寻优算法. 研究目标是确保在强连通有向图拓扑下, 所有智能体能在预设时间内协同收敛至广义纳什均衡. 为克服通信拓扑权重不平衡带来的系统偏差, 算法采用两阶段收敛策略: 第一阶段利用一致性机制精确估计拉普拉斯矩阵的左特征向量, 实现拓扑补偿; 第二阶段通过引入阻尼项支持二阶积分型系统的稳定性分析, 并结合拉格朗日乘子法处理全局约束, 同时利用基于领导−跟随一致性协议的估计器重构对手的决策信息, 以实现伪梯度的分布式更新. 此外, 针对权重平衡有向图这一特殊情形, 给出算法的简化实现形式. 在博弈映射满足强单调性假设下, 通过引入时间变换函数并构造新型李雅普诺夫函数, 从理论上严格证明系统能够在预设时间内收敛至广义纳什均衡, 并确保收敛后的持续稳定性. 最后, 数值仿真实验验证了算法在不同拓扑结构下的有效性与收敛精度.
针对一类带有全局耦合等式约束的分布式非合作博弈问题, 提出一种适用于二阶多智能体系统的预设时间分布式寻优算法. 研究目标是确保在强连通有向图拓扑下, 所有智能体能在预设时间内协同收敛至广义纳什均衡. 为克服通信拓扑权重不平衡带来的系统偏差, 算法采用两阶段收敛策略: 第一阶段利用一致性机制精确估计拉普拉斯矩阵的左特征向量, 实现拓扑补偿; 第二阶段通过引入阻尼项支持二阶积分型系统的稳定性分析, 并结合拉格朗日乘子法处理全局约束, 同时利用基于领导−跟随一致性协议的估计器重构对手的决策信息, 以实现伪梯度的分布式更新. 此外, 针对权重平衡有向图这一特殊情形, 给出算法的简化实现形式. 在博弈映射满足强单调性假设下, 通过引入时间变换函数并构造新型李雅普诺夫函数, 从理论上严格证明系统能够在预设时间内收敛至广义纳什均衡, 并确保收敛后的持续稳定性. 最后, 数值仿真实验验证了算法在不同拓扑结构下的有效性与收敛精度.


2026, 52(10): 2241-2260.
doi: 10.16383/j.aas.c260075
cstr: 32138.14.j.aas.c260075
摘要:
针对大规模网络化无人艇集群面临的通信资源受限、成员收益最大化问题, 提出一种基于边分组通信机制的博弈编队控制方案. 首先, 构造具有时变纳什均衡点的代价函数, 使编队成员能够通过动态博弈过程最大化自身收益, 并逐步形成期望的编队构型; 同时, 为每个成员设计分布式状态估计器, 以降低博弈过程对全局信息的依赖. 其次, 考虑大规模集群系统多边并发通信易导致信道拥塞、延迟、丢包等问题, 通过边分组通信机制将通信边划分成组, 并由各组自主生成相互交错的通信时间序列, 使各边通信错峰进行, 在各自的通信时刻避免竞争. 最后, 通过理论分析与数值仿真验证了所提控制方案的有效性与优越性.
针对大规模网络化无人艇集群面临的通信资源受限、成员收益最大化问题, 提出一种基于边分组通信机制的博弈编队控制方案. 首先, 构造具有时变纳什均衡点的代价函数, 使编队成员能够通过动态博弈过程最大化自身收益, 并逐步形成期望的编队构型; 同时, 为每个成员设计分布式状态估计器, 以降低博弈过程对全局信息的依赖. 其次, 考虑大规模集群系统多边并发通信易导致信道拥塞、延迟、丢包等问题, 通过边分组通信机制将通信边划分成组, 并由各组自主生成相互交错的通信时间序列, 使各边通信错峰进行, 在各自的通信时刻避免竞争. 最后, 通过理论分析与数值仿真验证了所提控制方案的有效性与优越性.


2026, 52(10): 2261-2273.
doi: 10.16383/j.aas.c250695
cstr: 32138.14.j.aas.c250695
摘要:
针对无人机集群在突发环境变化下易出现性能退化的问题, 提出一种基于动态性能均衡的元学习控制方法, 以实现集群系统高效、可靠的在线自适应协同控制. 首先, 基于无人机不确定动力学模型, 结合轨迹跟踪、集群协同与动态障碍物规避等多重约束, 构建一类能够有效抵御系统不确定性与外部扰动的自适应控制策略. 其次, 为解决瞬态响应与稳态精度之间的性能冲突, 并克服传统优化算法计算耗时长的局限, 构建元学习控制架构. 该方法通过离线训练习得具备强泛化能力的初始化参数, 使系统在线仅需利用少量历史数据和单步梯度更新, 即可实现毫秒级自适应并快速收敛至满足动态性能均衡要求的最优增益. 实验结果验证了该方法在动态障碍物及剧烈环境变化场景下的显著适应能力, 实现了兼具鲁棒性、安全性与高性能的协同控制.
针对无人机集群在突发环境变化下易出现性能退化的问题, 提出一种基于动态性能均衡的元学习控制方法, 以实现集群系统高效、可靠的在线自适应协同控制. 首先, 基于无人机不确定动力学模型, 结合轨迹跟踪、集群协同与动态障碍物规避等多重约束, 构建一类能够有效抵御系统不确定性与外部扰动的自适应控制策略. 其次, 为解决瞬态响应与稳态精度之间的性能冲突, 并克服传统优化算法计算耗时长的局限, 构建元学习控制架构. 该方法通过离线训练习得具备强泛化能力的初始化参数, 使系统在线仅需利用少量历史数据和单步梯度更新, 即可实现毫秒级自适应并快速收敛至满足动态性能均衡要求的最优增益. 实验结果验证了该方法在动态障碍物及剧烈环境变化场景下的显著适应能力, 实现了兼具鲁棒性、安全性与高性能的协同控制.


2026, 52(10): 2274-2285.
doi: 10.16383/j.aas.c260069
cstr: 32138.14.j.aas.c260069
摘要:
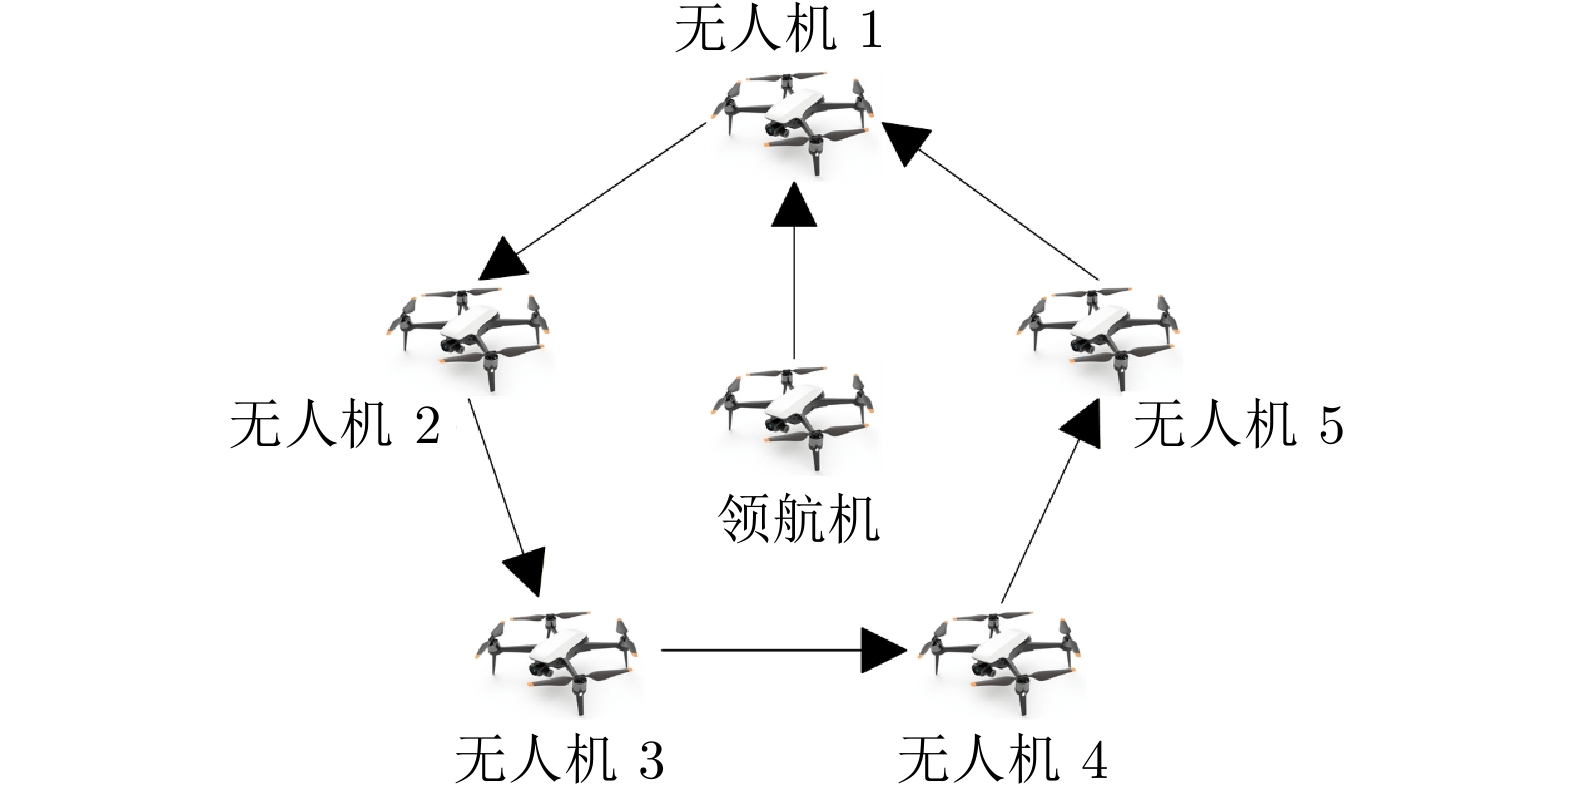
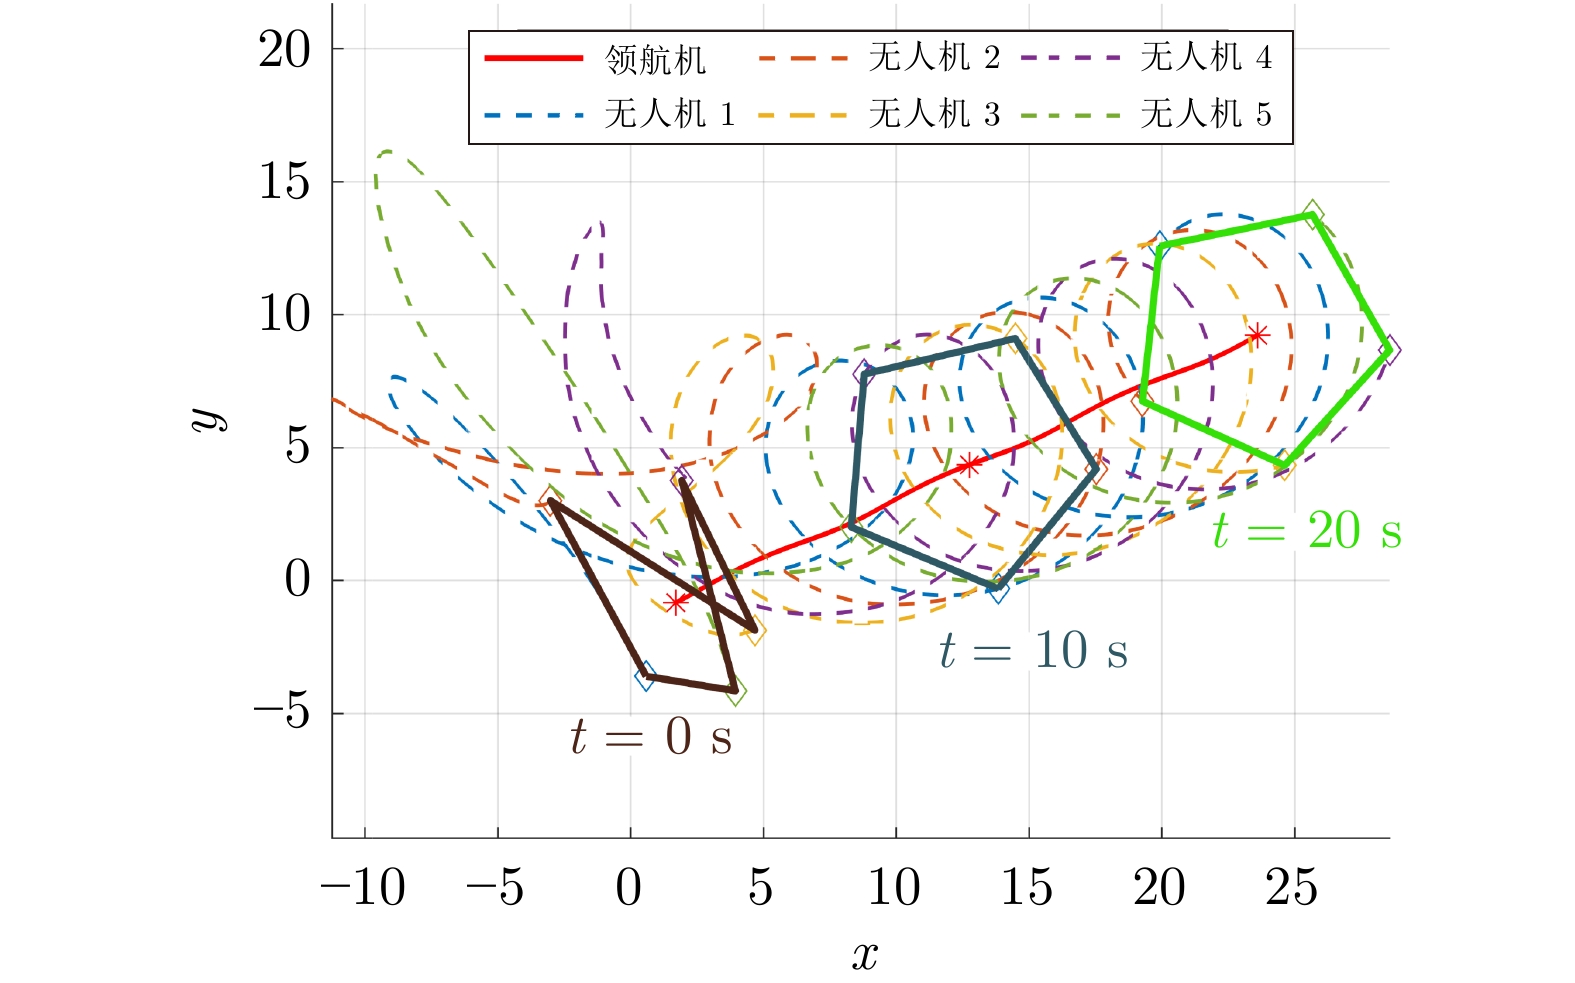
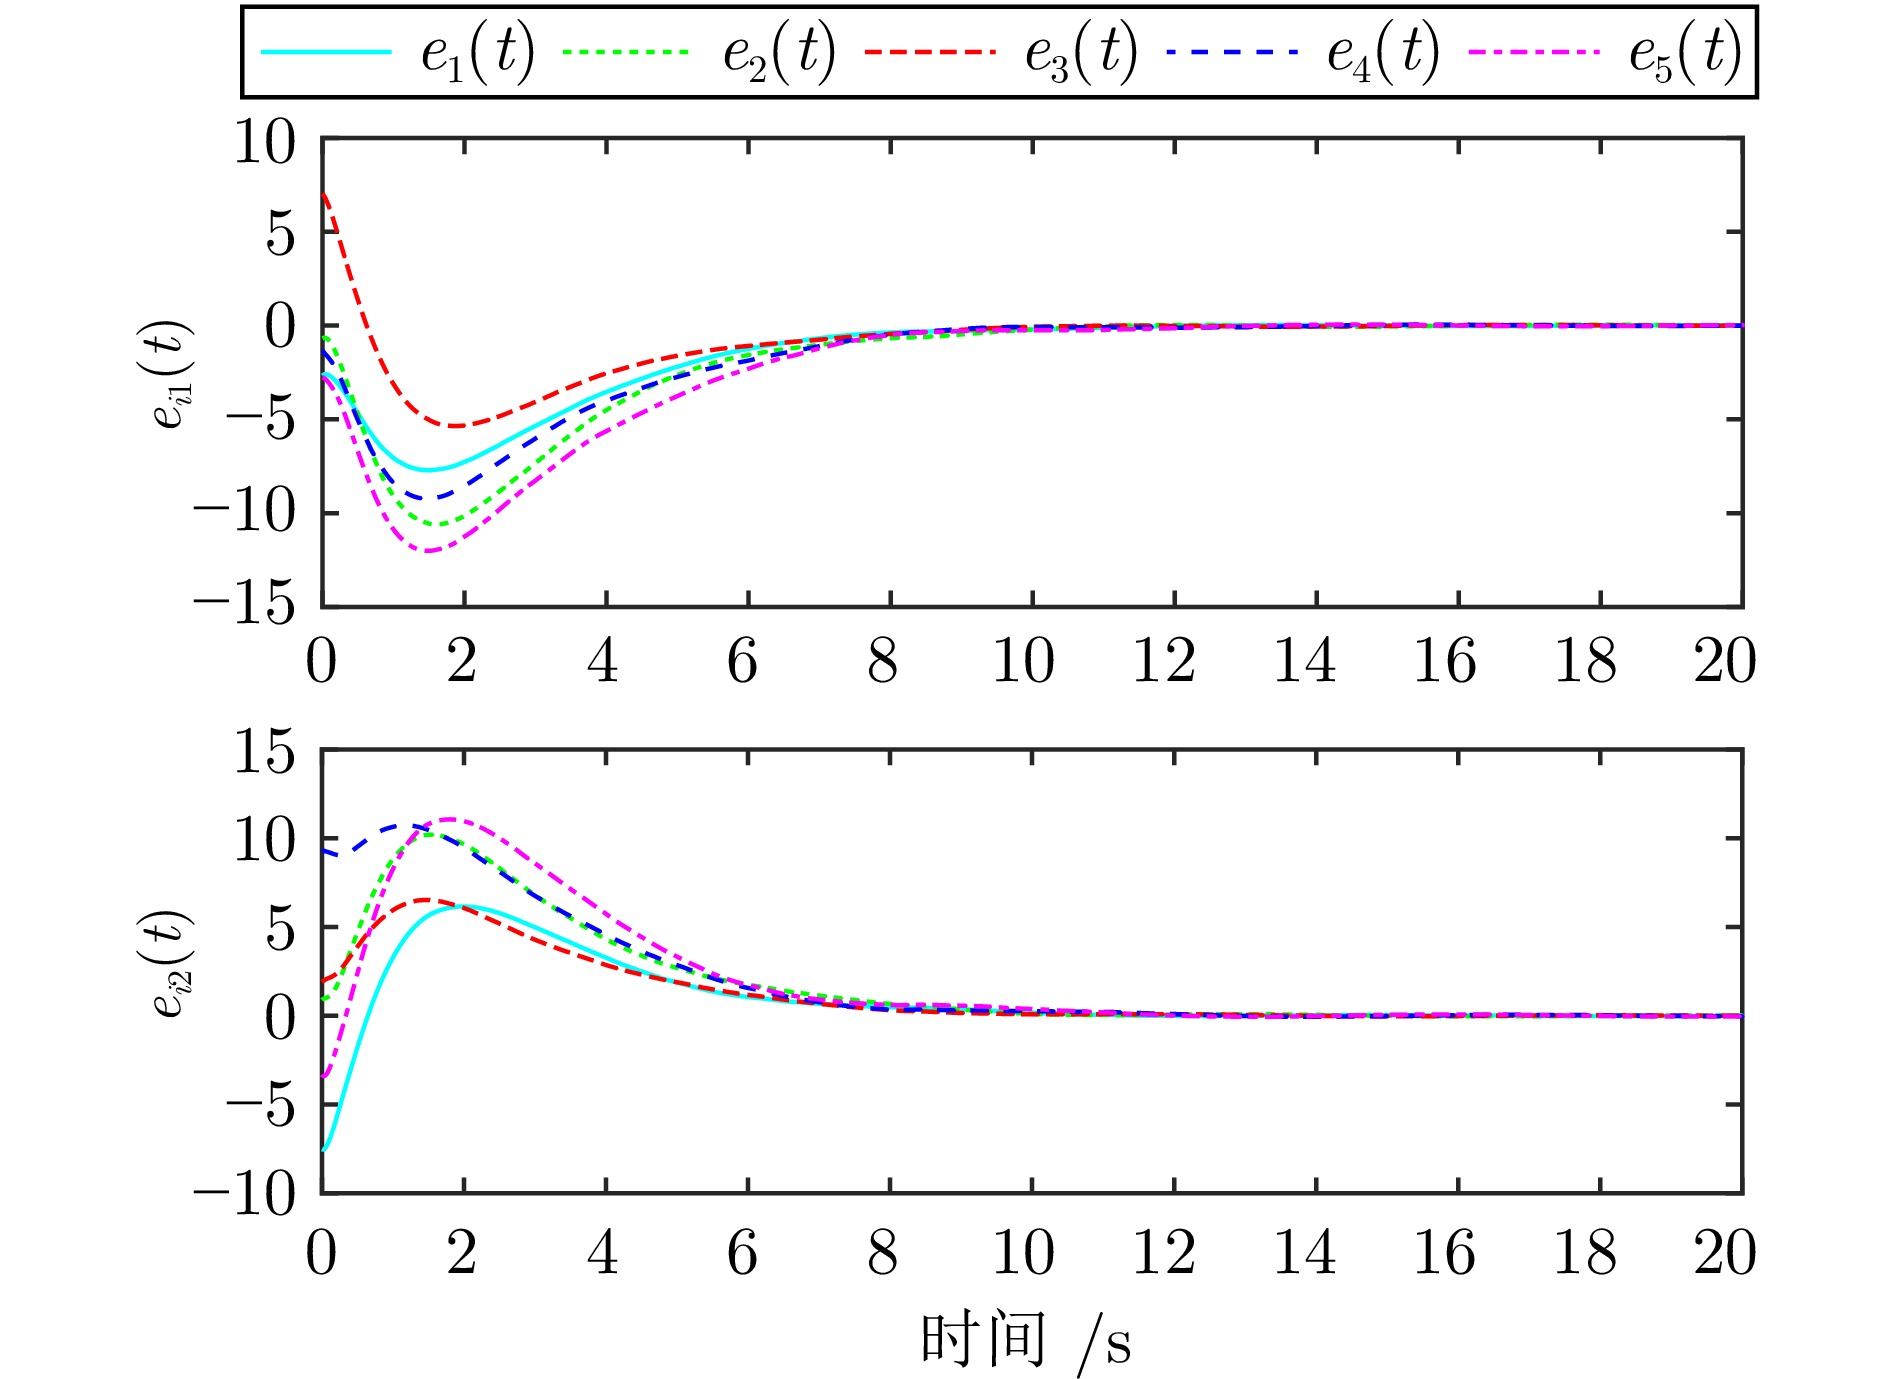
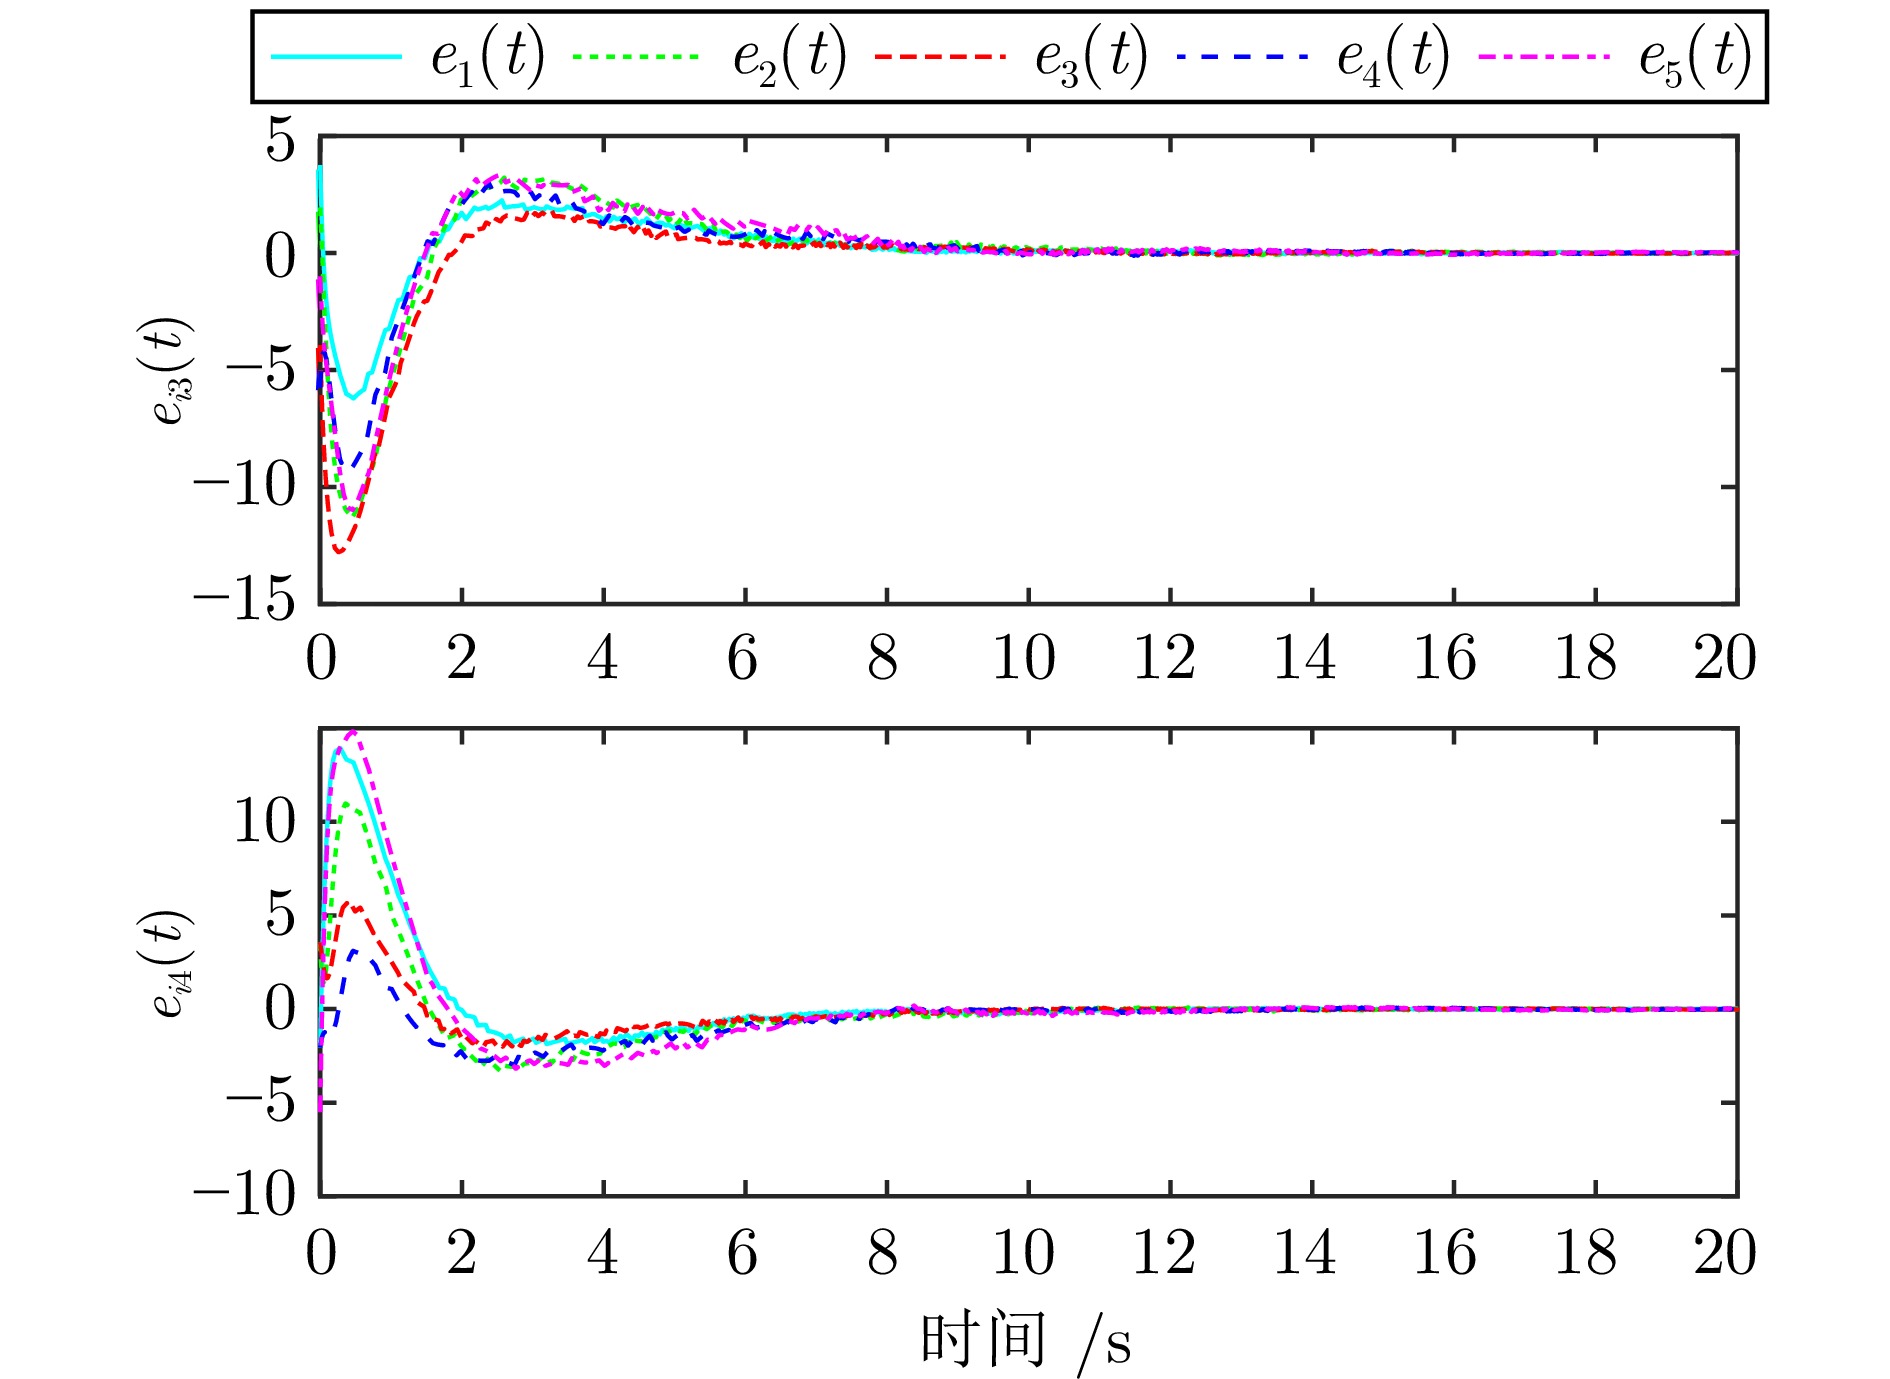
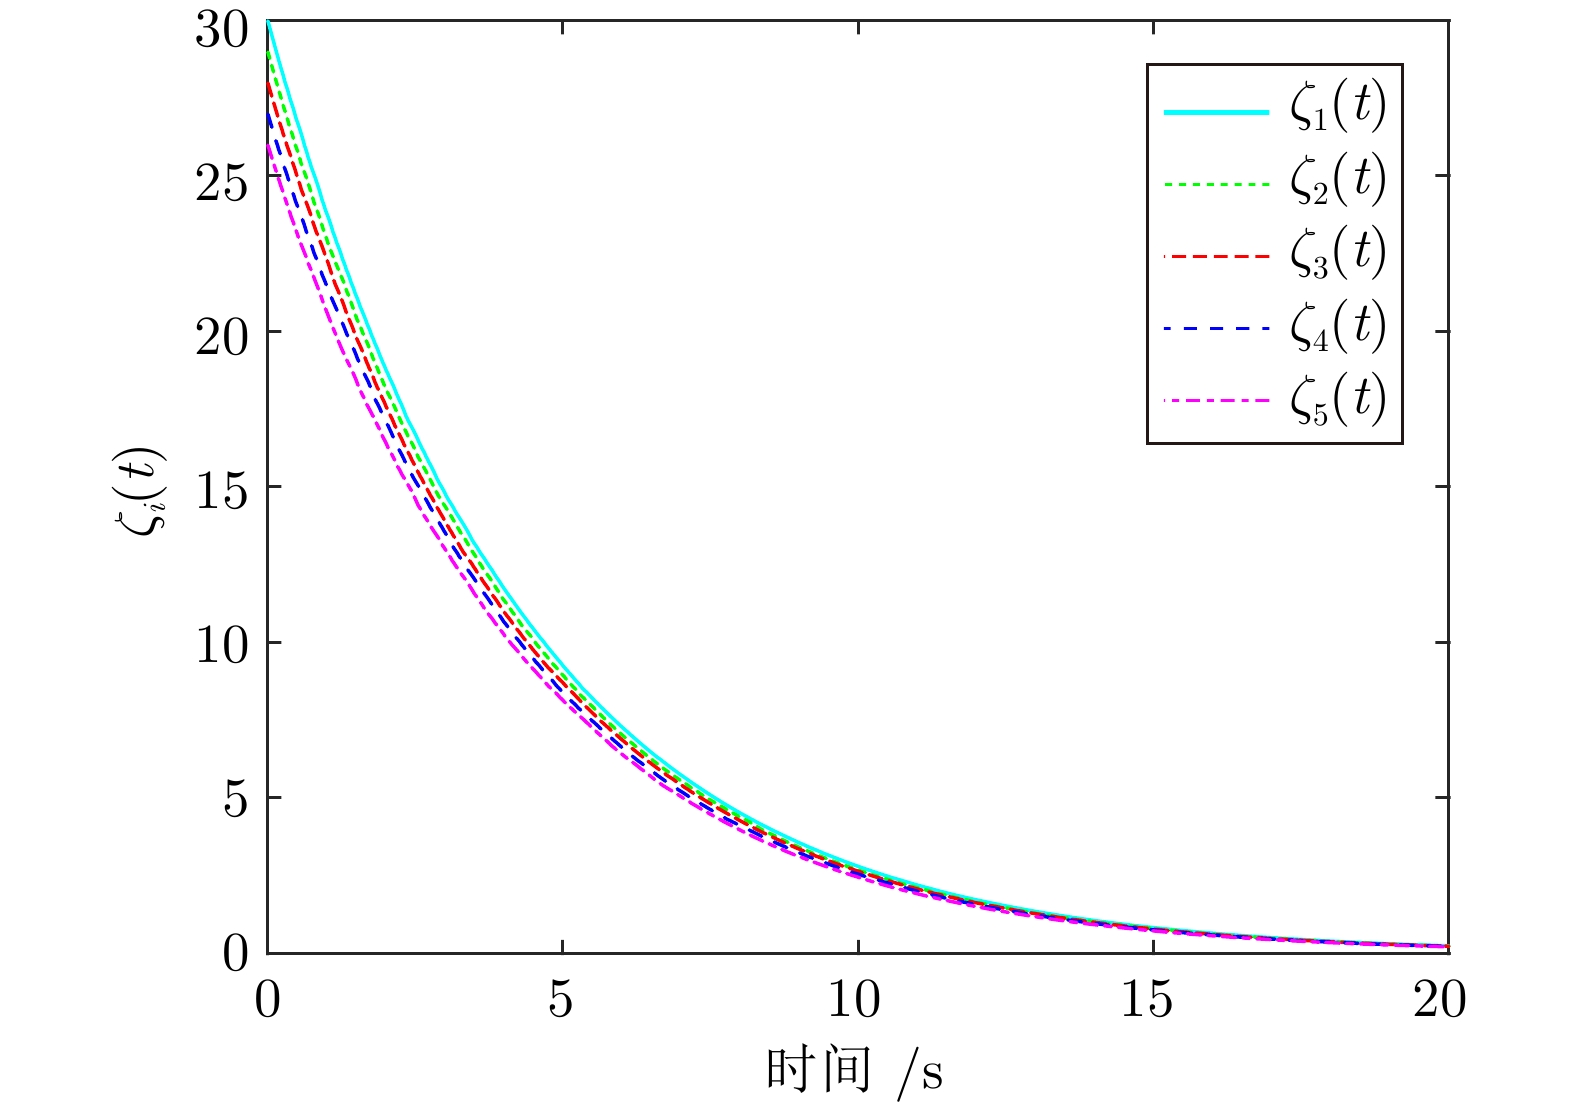
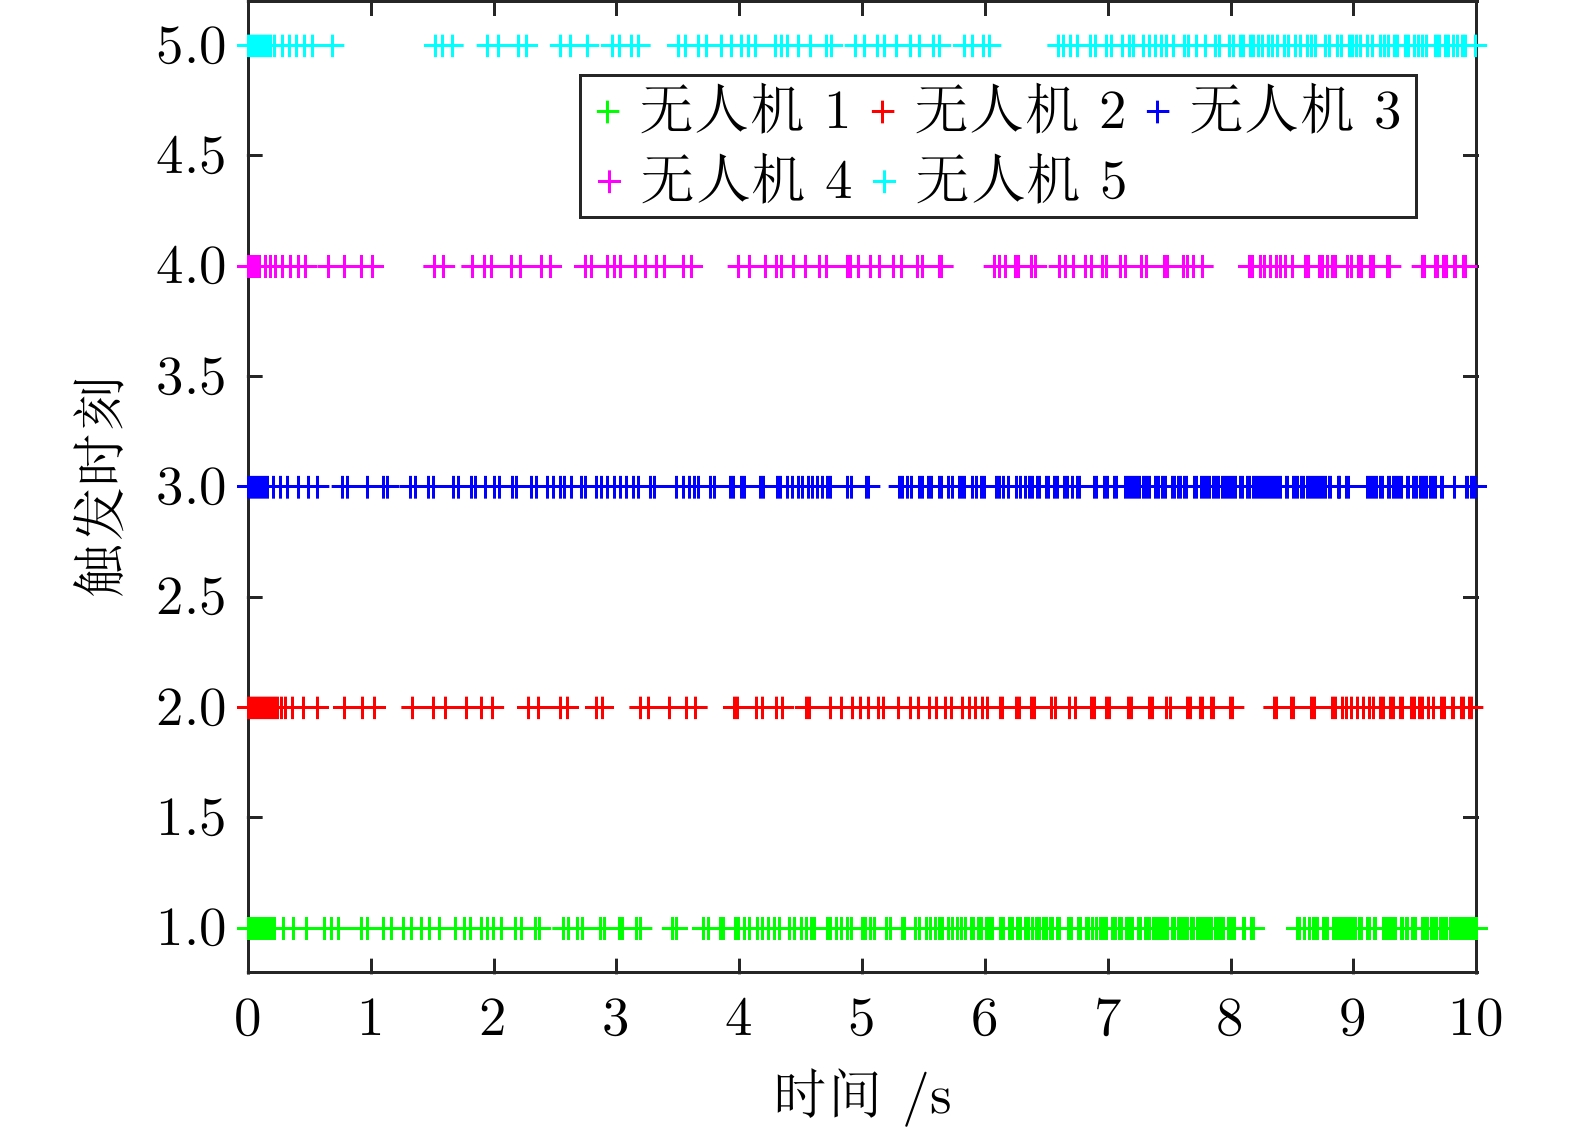
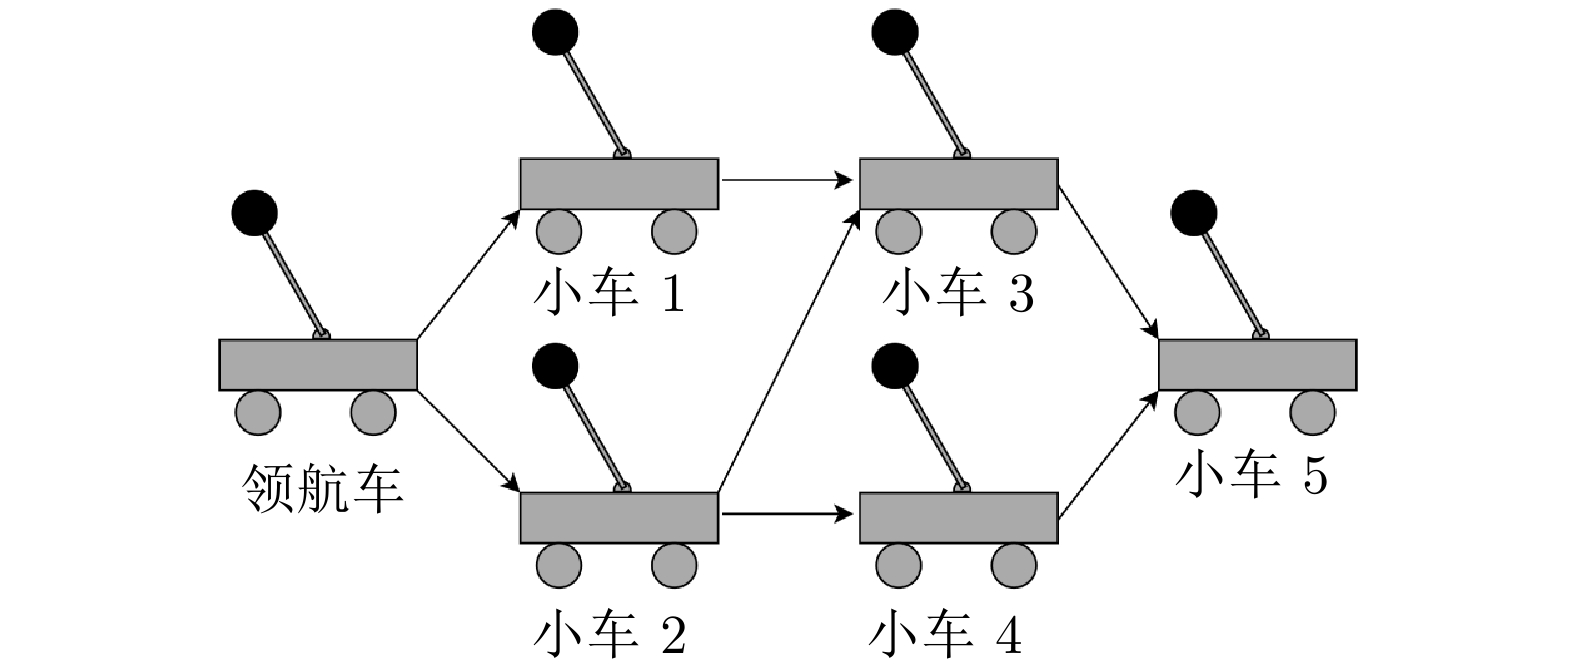
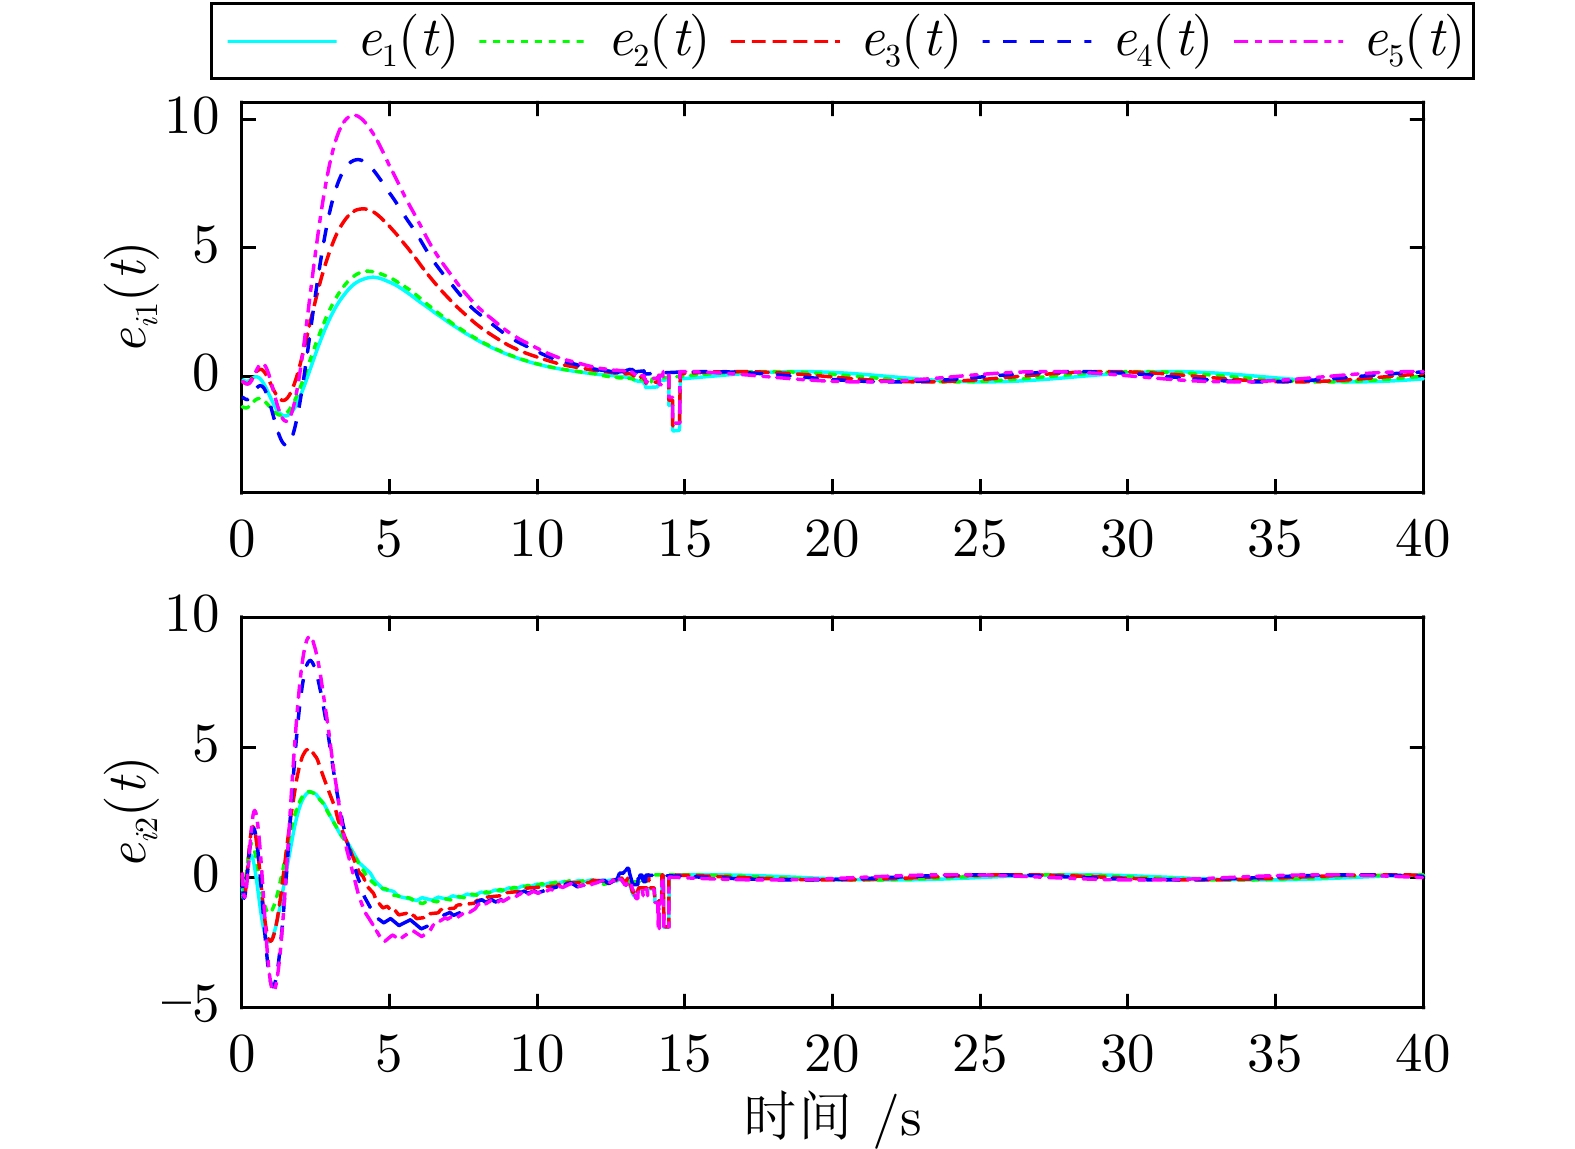
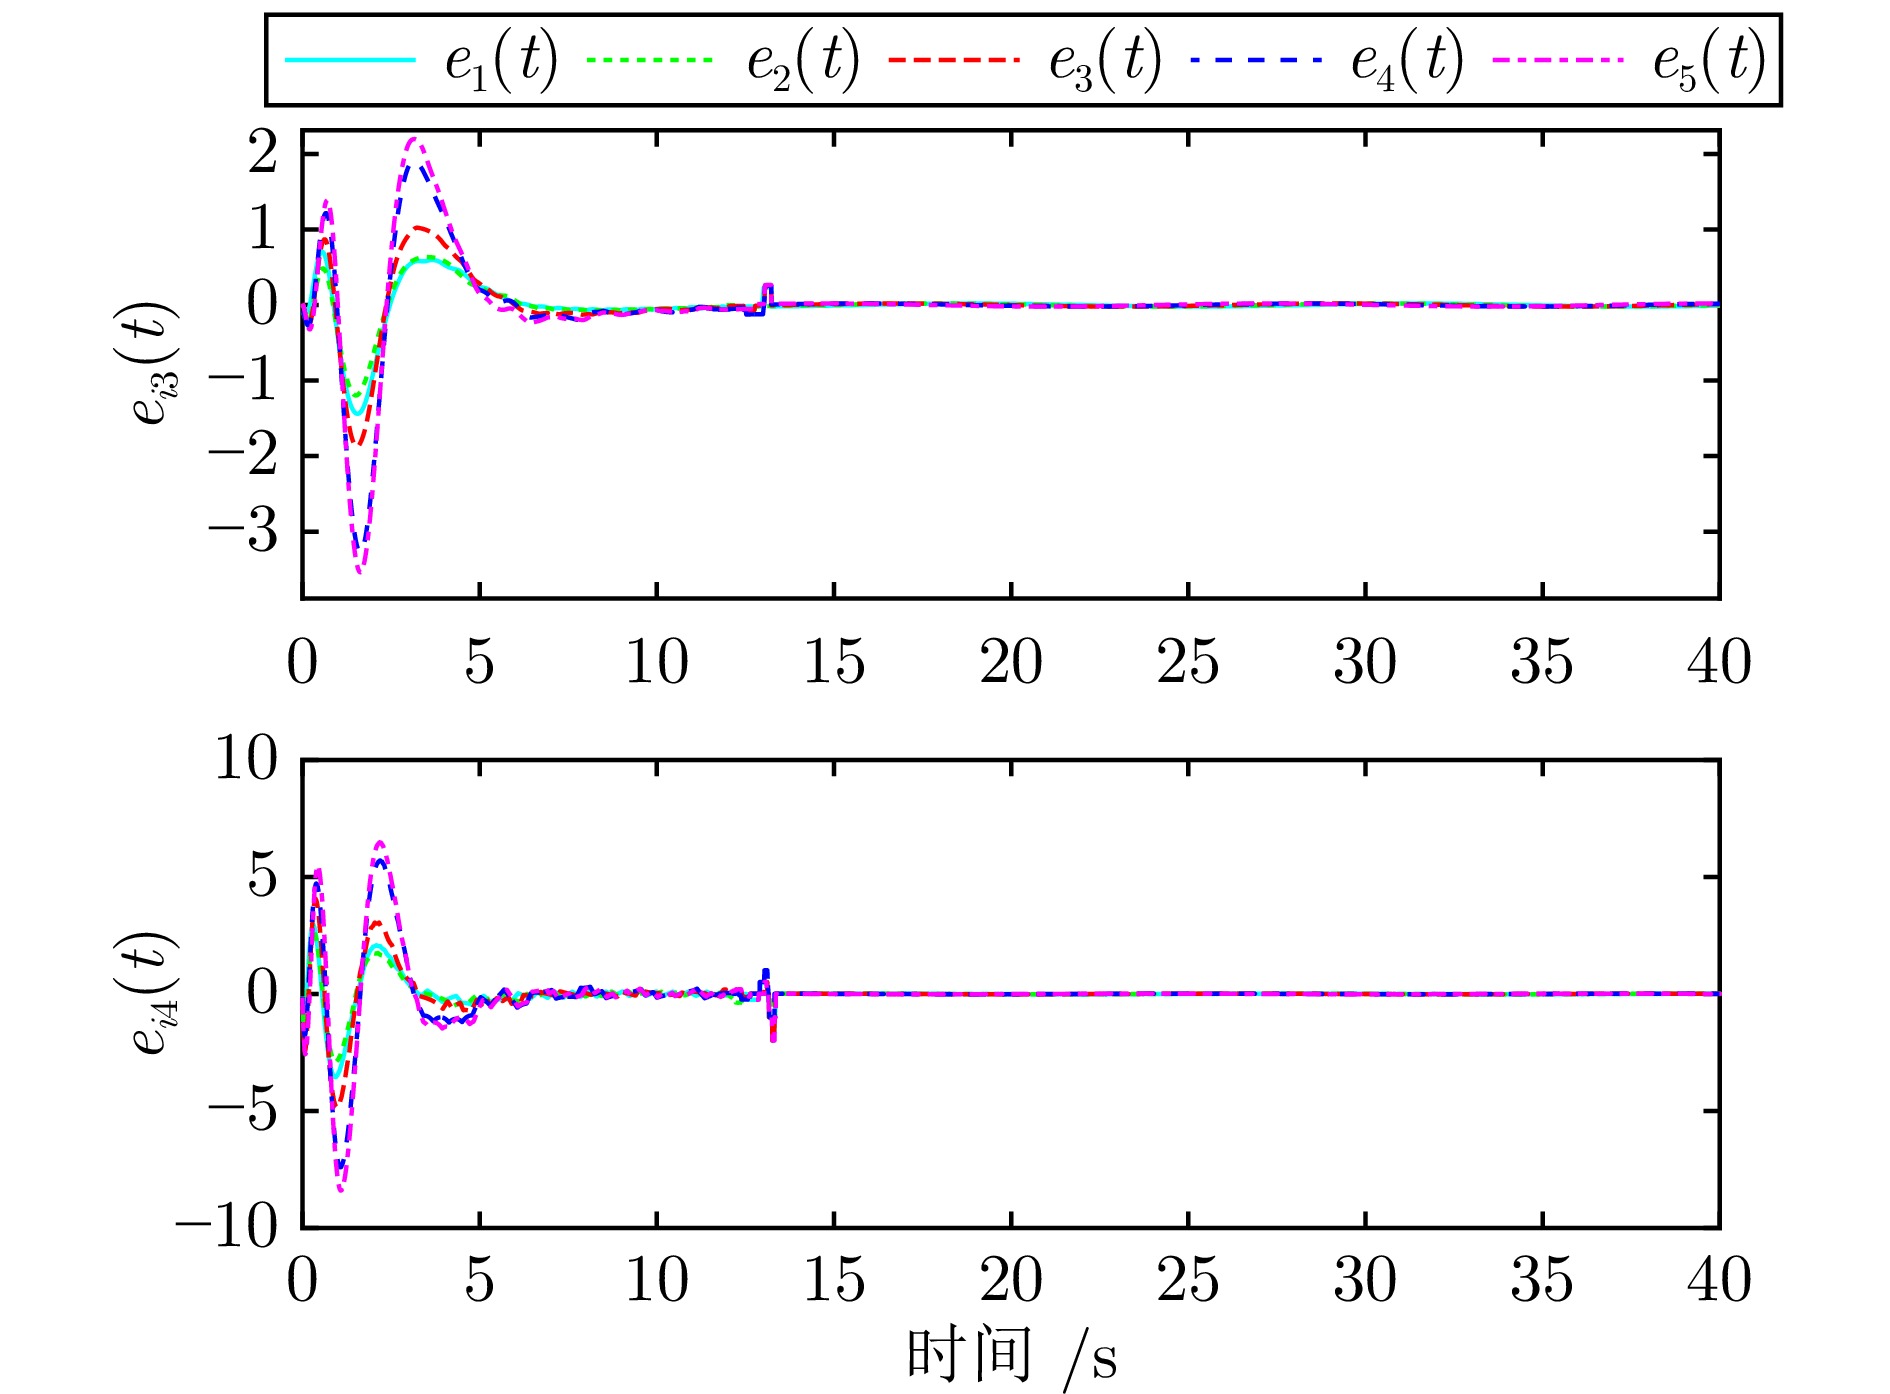
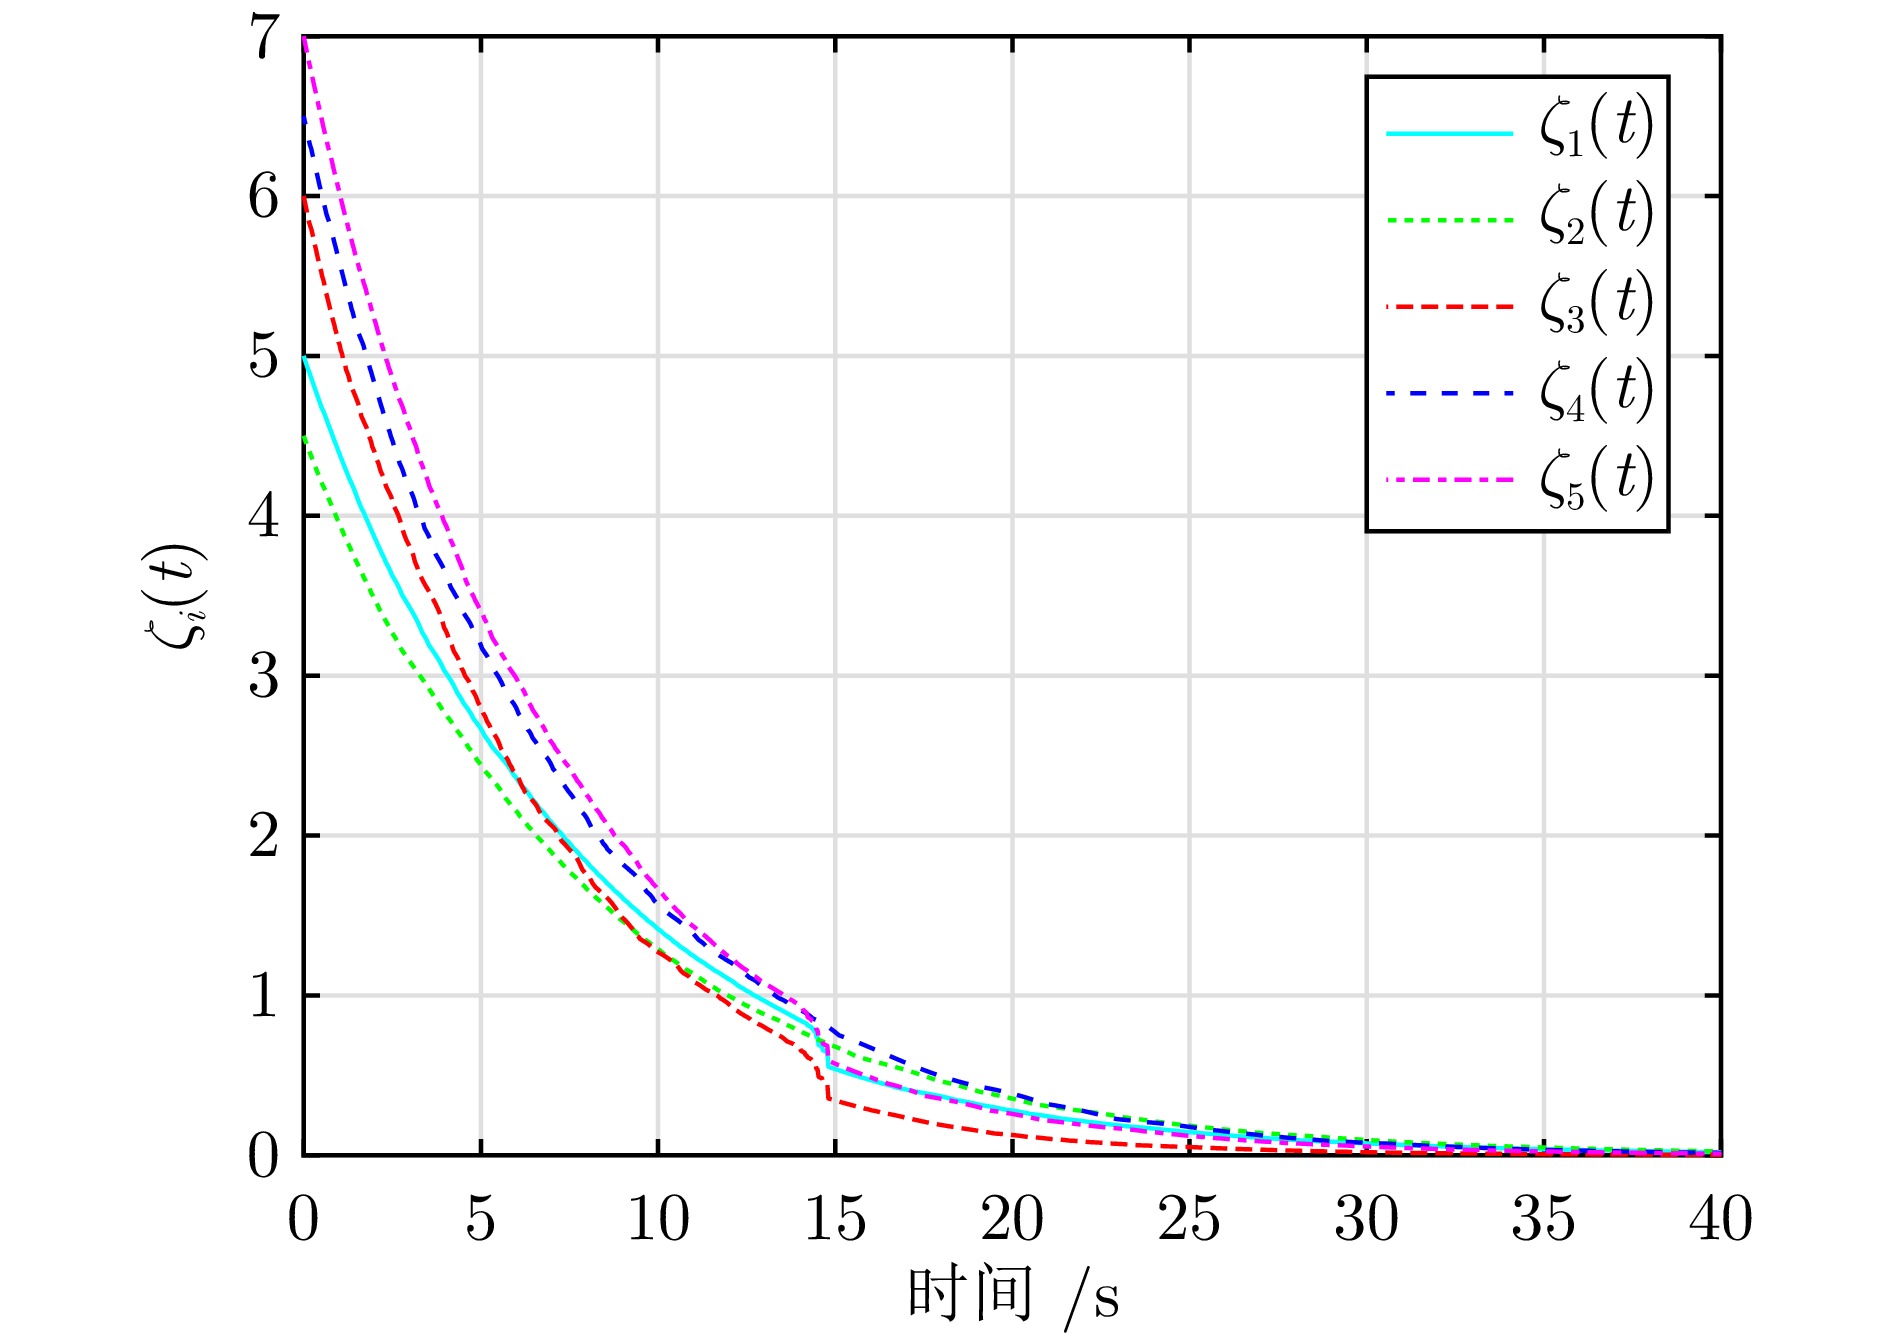
针对有向拓扑下含非自治领导者的多智能体系统, 提出一种基于未知输入观测器的分布式动态事件触发控制方法, 以解决其时变编队跟踪问题. 首先, 利用智能体之间的相对输出信息设计未知输入观测器, 以估计智能体之间的相对状态. 在此基础上, 引入动态事件触发机制来确定控制输入的更新时刻, 从而有效降低控制更新频率. 随后, 设计一种时变编队跟踪控制协议, 使得跟随者仅依赖相对输出信息即可实现对非自治领导者的编队跟踪. 通过构造合适的Lyapunov函数, 严格证明了编队跟踪误差的渐近收敛性. 此外, 借助反证法严格排除了芝诺行为. 最后, 数值仿真结果验证了所提方法的有效性.
针对有向拓扑下含非自治领导者的多智能体系统, 提出一种基于未知输入观测器的分布式动态事件触发控制方法, 以解决其时变编队跟踪问题. 首先, 利用智能体之间的相对输出信息设计未知输入观测器, 以估计智能体之间的相对状态. 在此基础上, 引入动态事件触发机制来确定控制输入的更新时刻, 从而有效降低控制更新频率. 随后, 设计一种时变编队跟踪控制协议, 使得跟随者仅依赖相对输出信息即可实现对非自治领导者的编队跟踪. 通过构造合适的Lyapunov函数, 严格证明了编队跟踪误差的渐近收敛性. 此外, 借助反证法严格排除了芝诺行为. 最后, 数值仿真结果验证了所提方法的有效性.
2026, 52(10): 2286-2298.
doi: 10.16383/j.aas.c260081
cstr: 32138.14.j.aas.c260081
摘要:
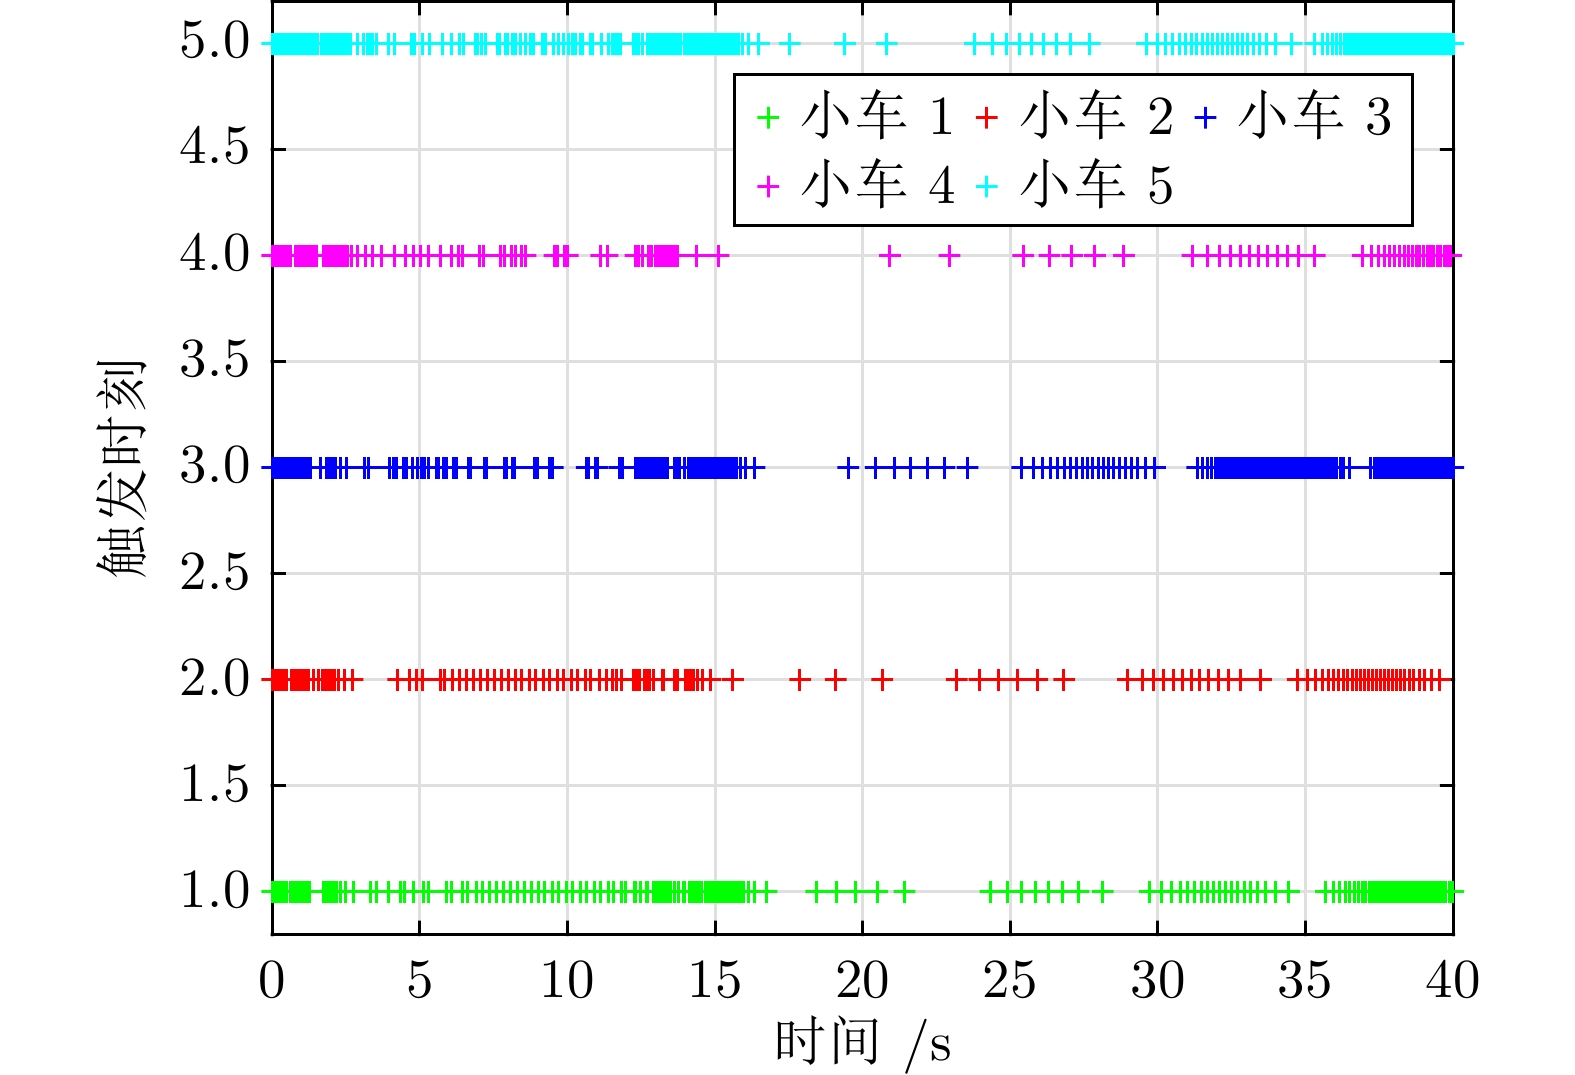
无人机技术的普及与滥用带来严峻空防挑战, 民用无人机“黑飞”威胁公共安全与基础设施, 军用无人机蜂群作战突破传统防空体系, 单一防御手段已难以应对. 因此, 提升对非合作无人机的协同跟踪与处置能力迫在眉睫. 作为无人机反制核心解决方案之一, 飞网协同围捕技术要求多无人机协同估计目标轨迹中心并自主编队完成捕获, 而分布式平均跟踪是实现该目标的关键理论. 针对此问题, 提出一种无需相对速度测量和变量初始化的集群无人机系统动态事件触发分布式平均跟踪算法; 理论分析证实, 该算法可实现分布式平均跟踪目标且闭环系统不存在芝诺现象; 最后以集群无人机跟踪非合作无人机集群为例, 验证了算法的有效性与实用性.
无人机技术的普及与滥用带来严峻空防挑战, 民用无人机“黑飞”威胁公共安全与基础设施, 军用无人机蜂群作战突破传统防空体系, 单一防御手段已难以应对. 因此, 提升对非合作无人机的协同跟踪与处置能力迫在眉睫. 作为无人机反制核心解决方案之一, 飞网协同围捕技术要求多无人机协同估计目标轨迹中心并自主编队完成捕获, 而分布式平均跟踪是实现该目标的关键理论. 针对此问题, 提出一种无需相对速度测量和变量初始化的集群无人机系统动态事件触发分布式平均跟踪算法; 理论分析证实, 该算法可实现分布式平均跟踪目标且闭环系统不存在芝诺现象; 最后以集群无人机跟踪非合作无人机集群为例, 验证了算法的有效性与实用性.


2026, 52(10): 2299-2306.
doi: 10.16383/j.aas.c260074
cstr: 32138.14.j.aas.c260074
摘要:
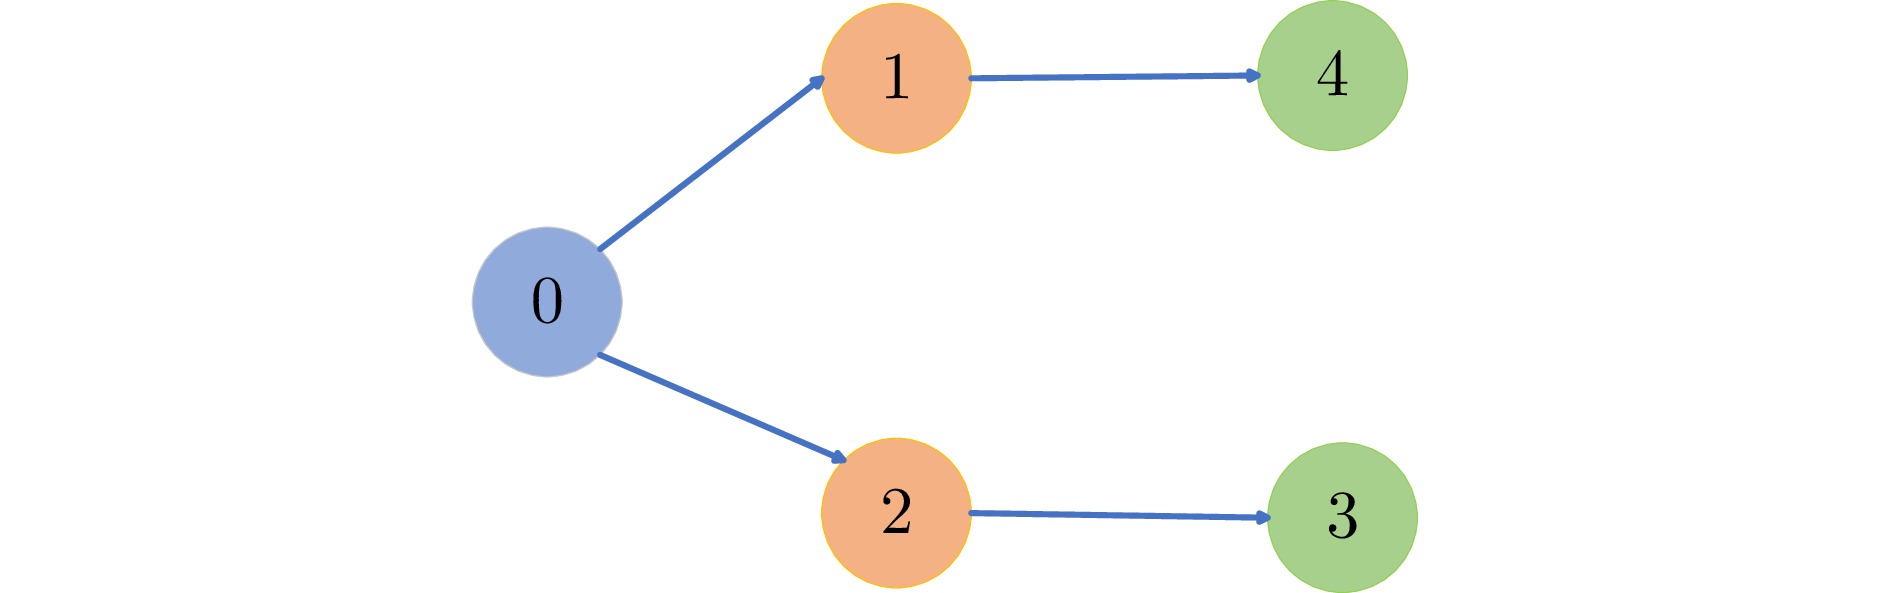
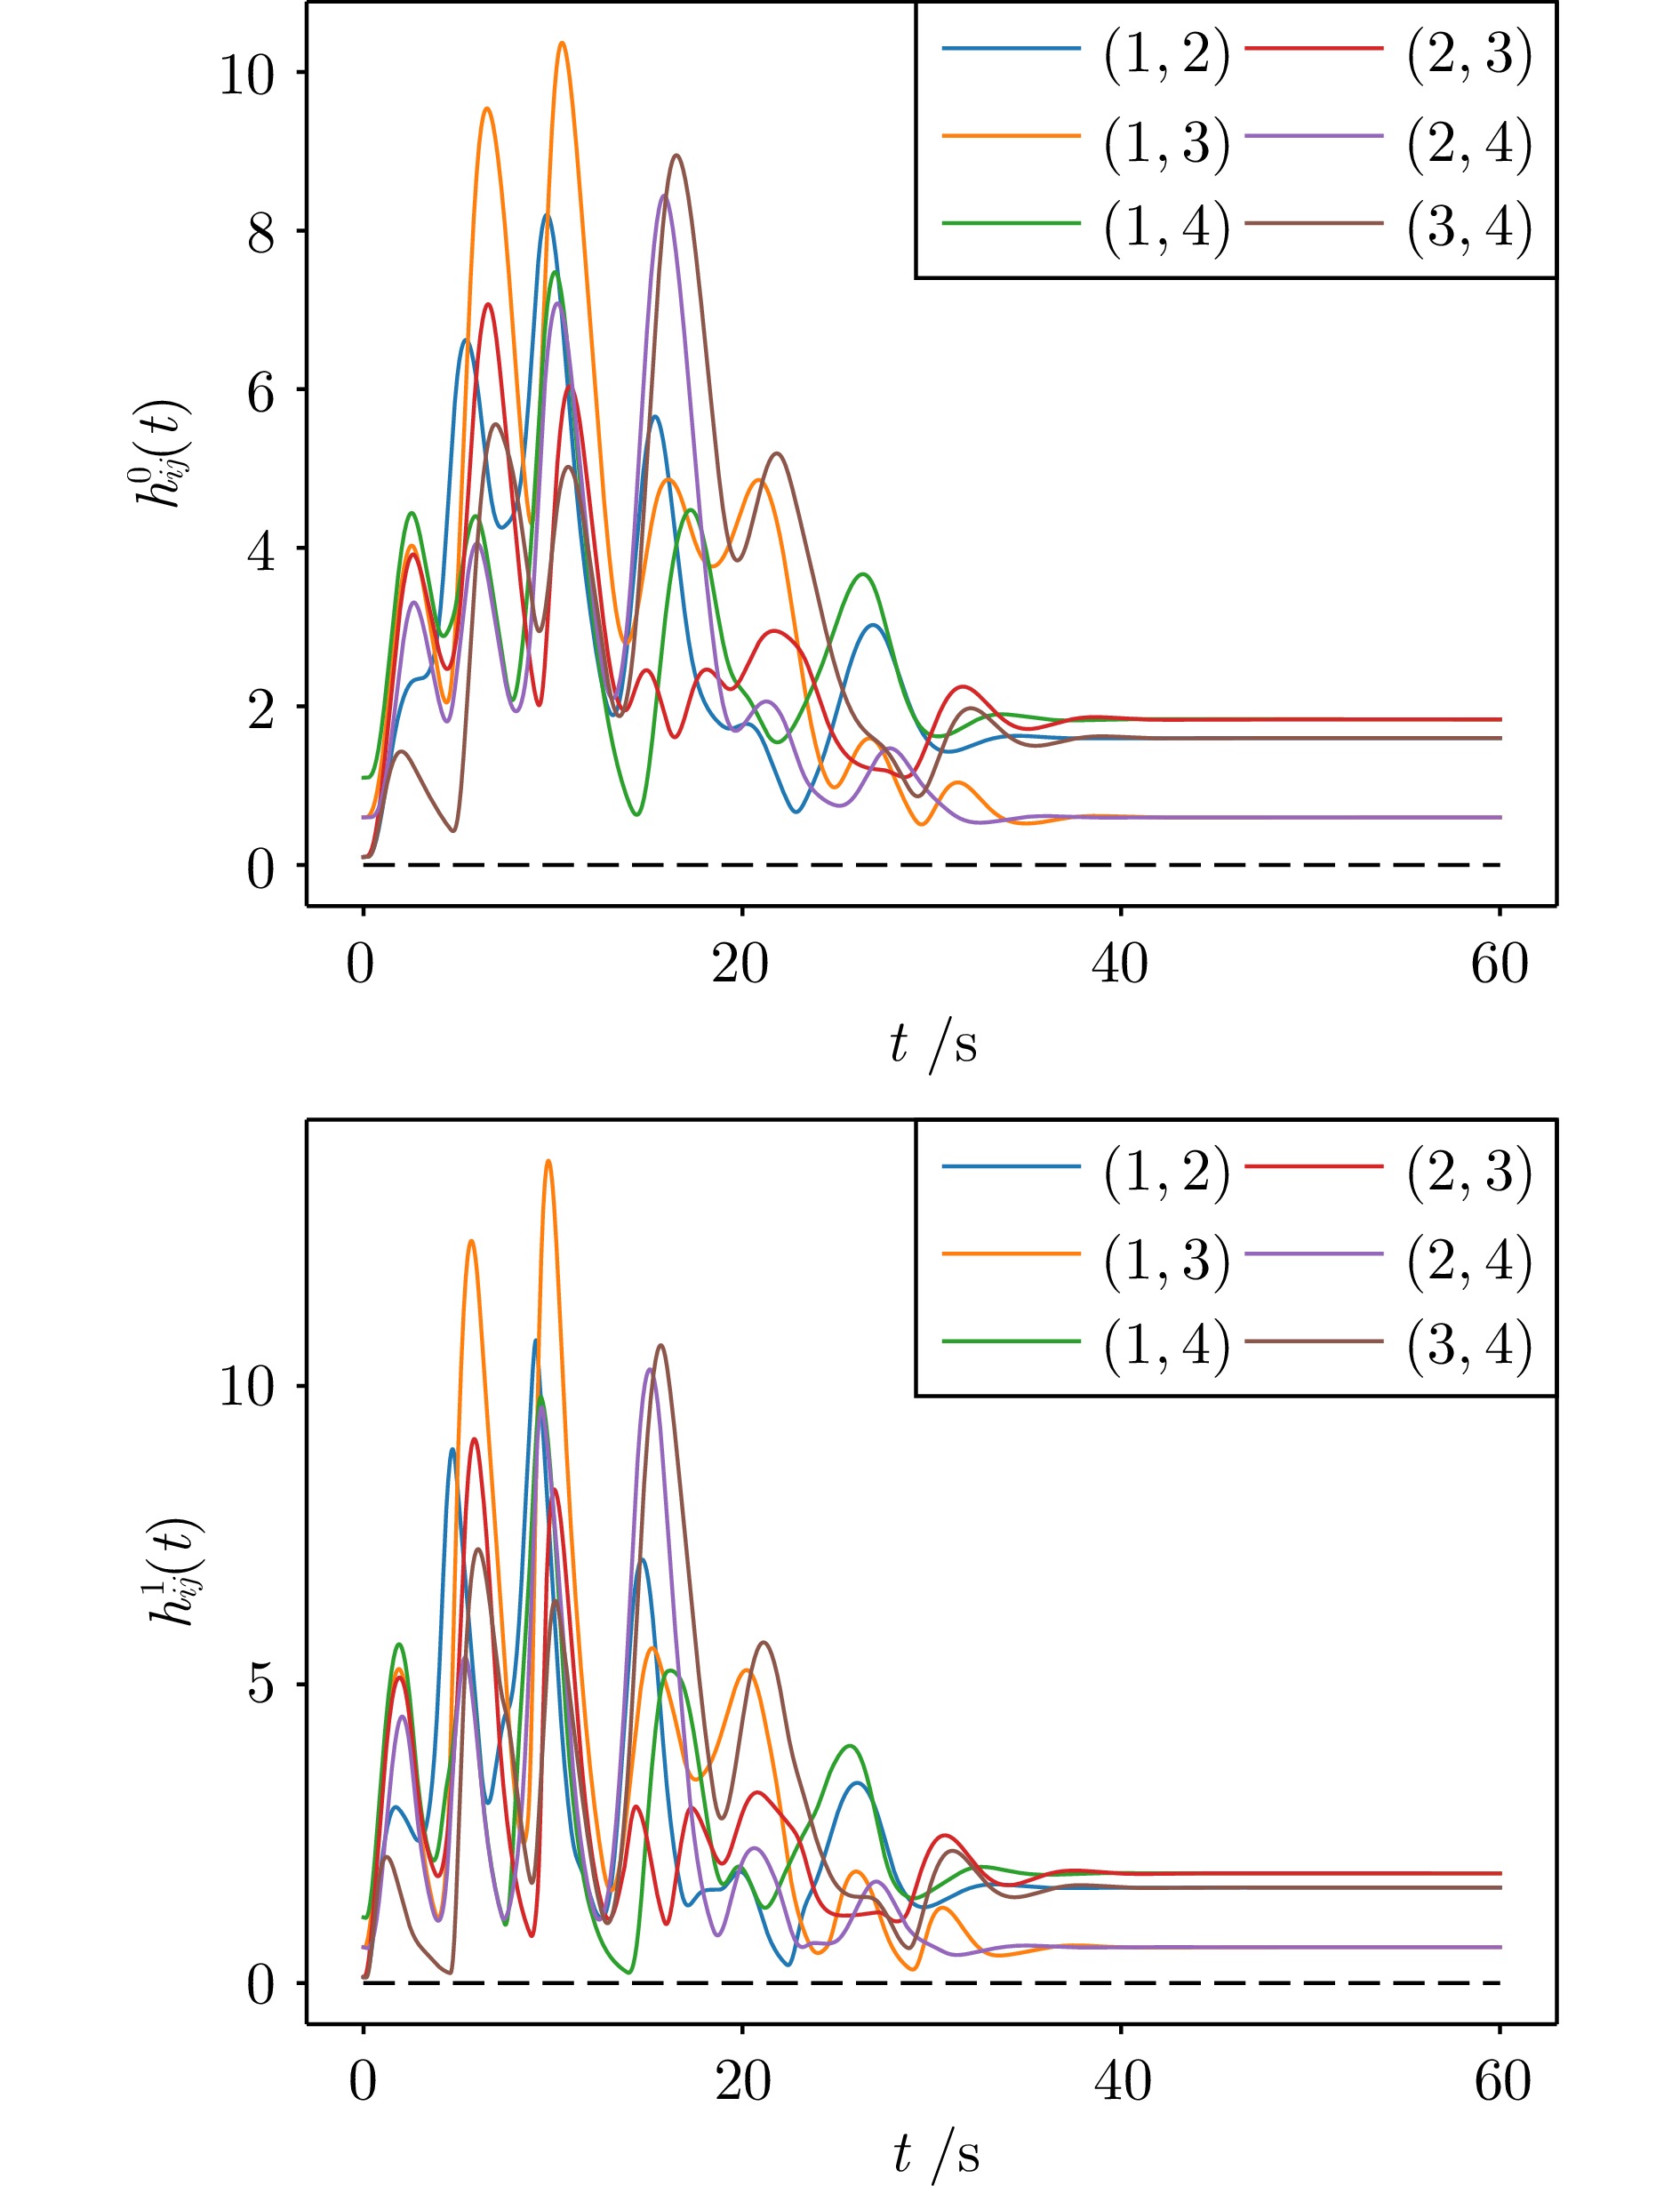
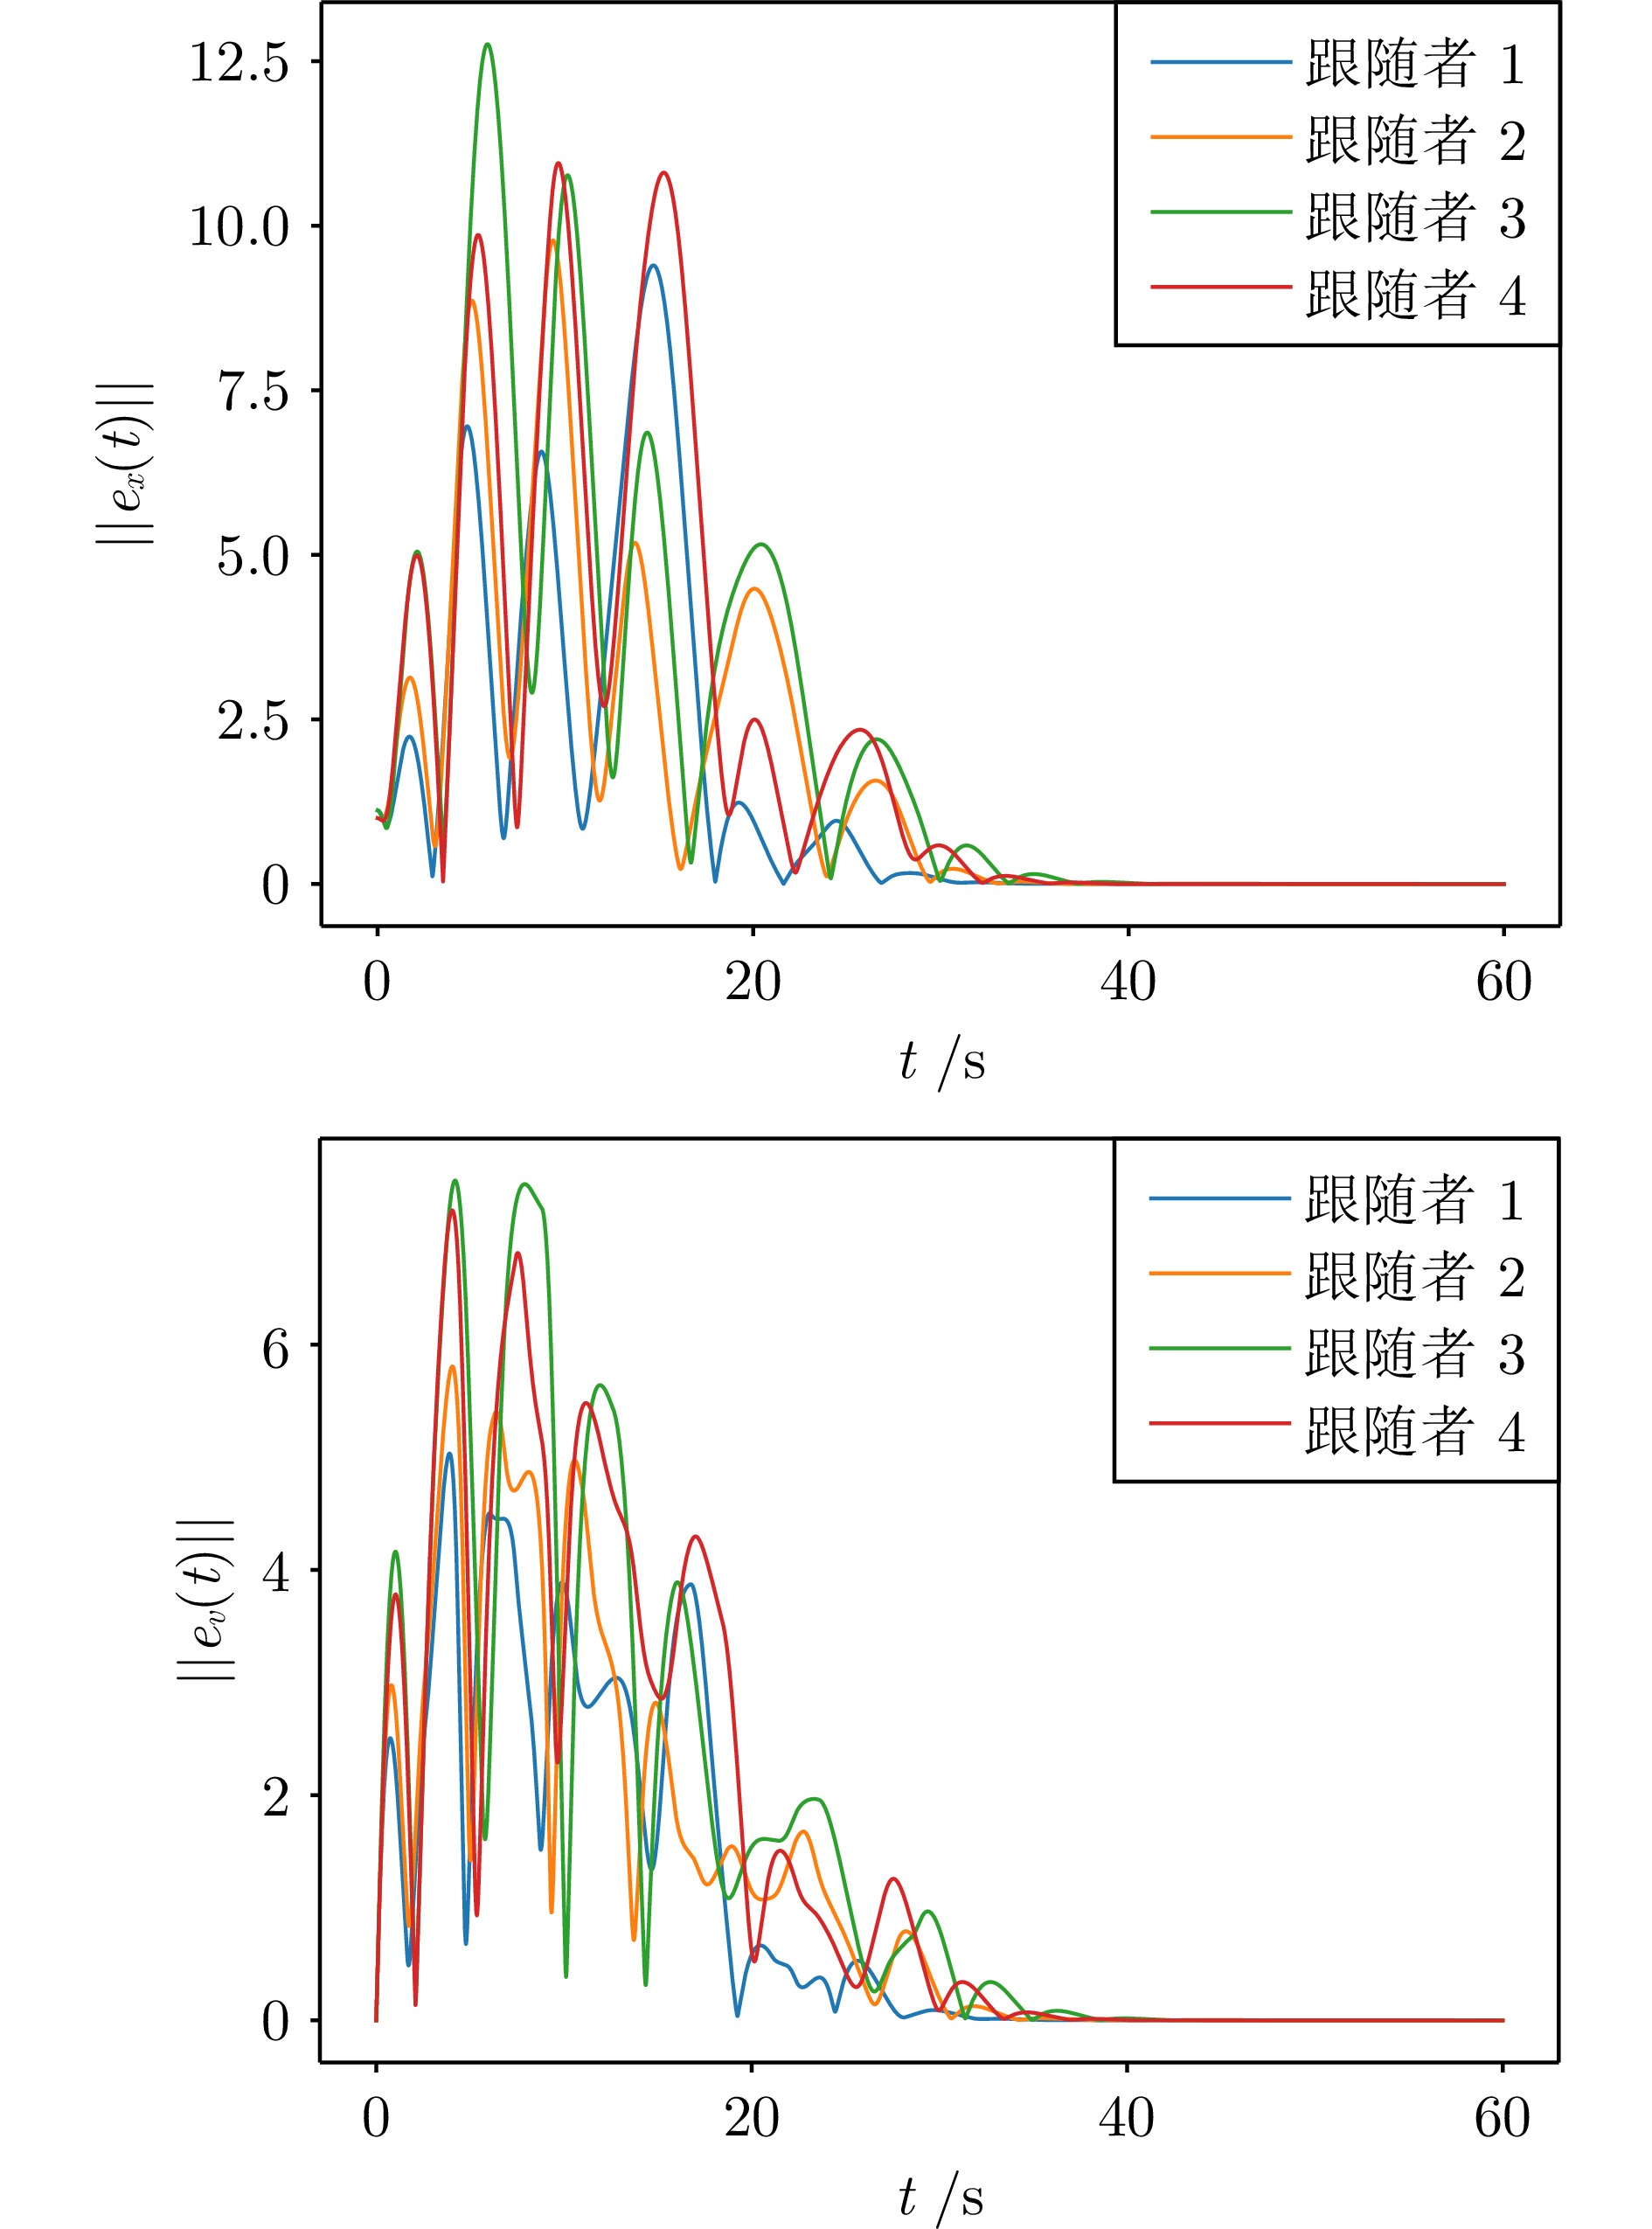
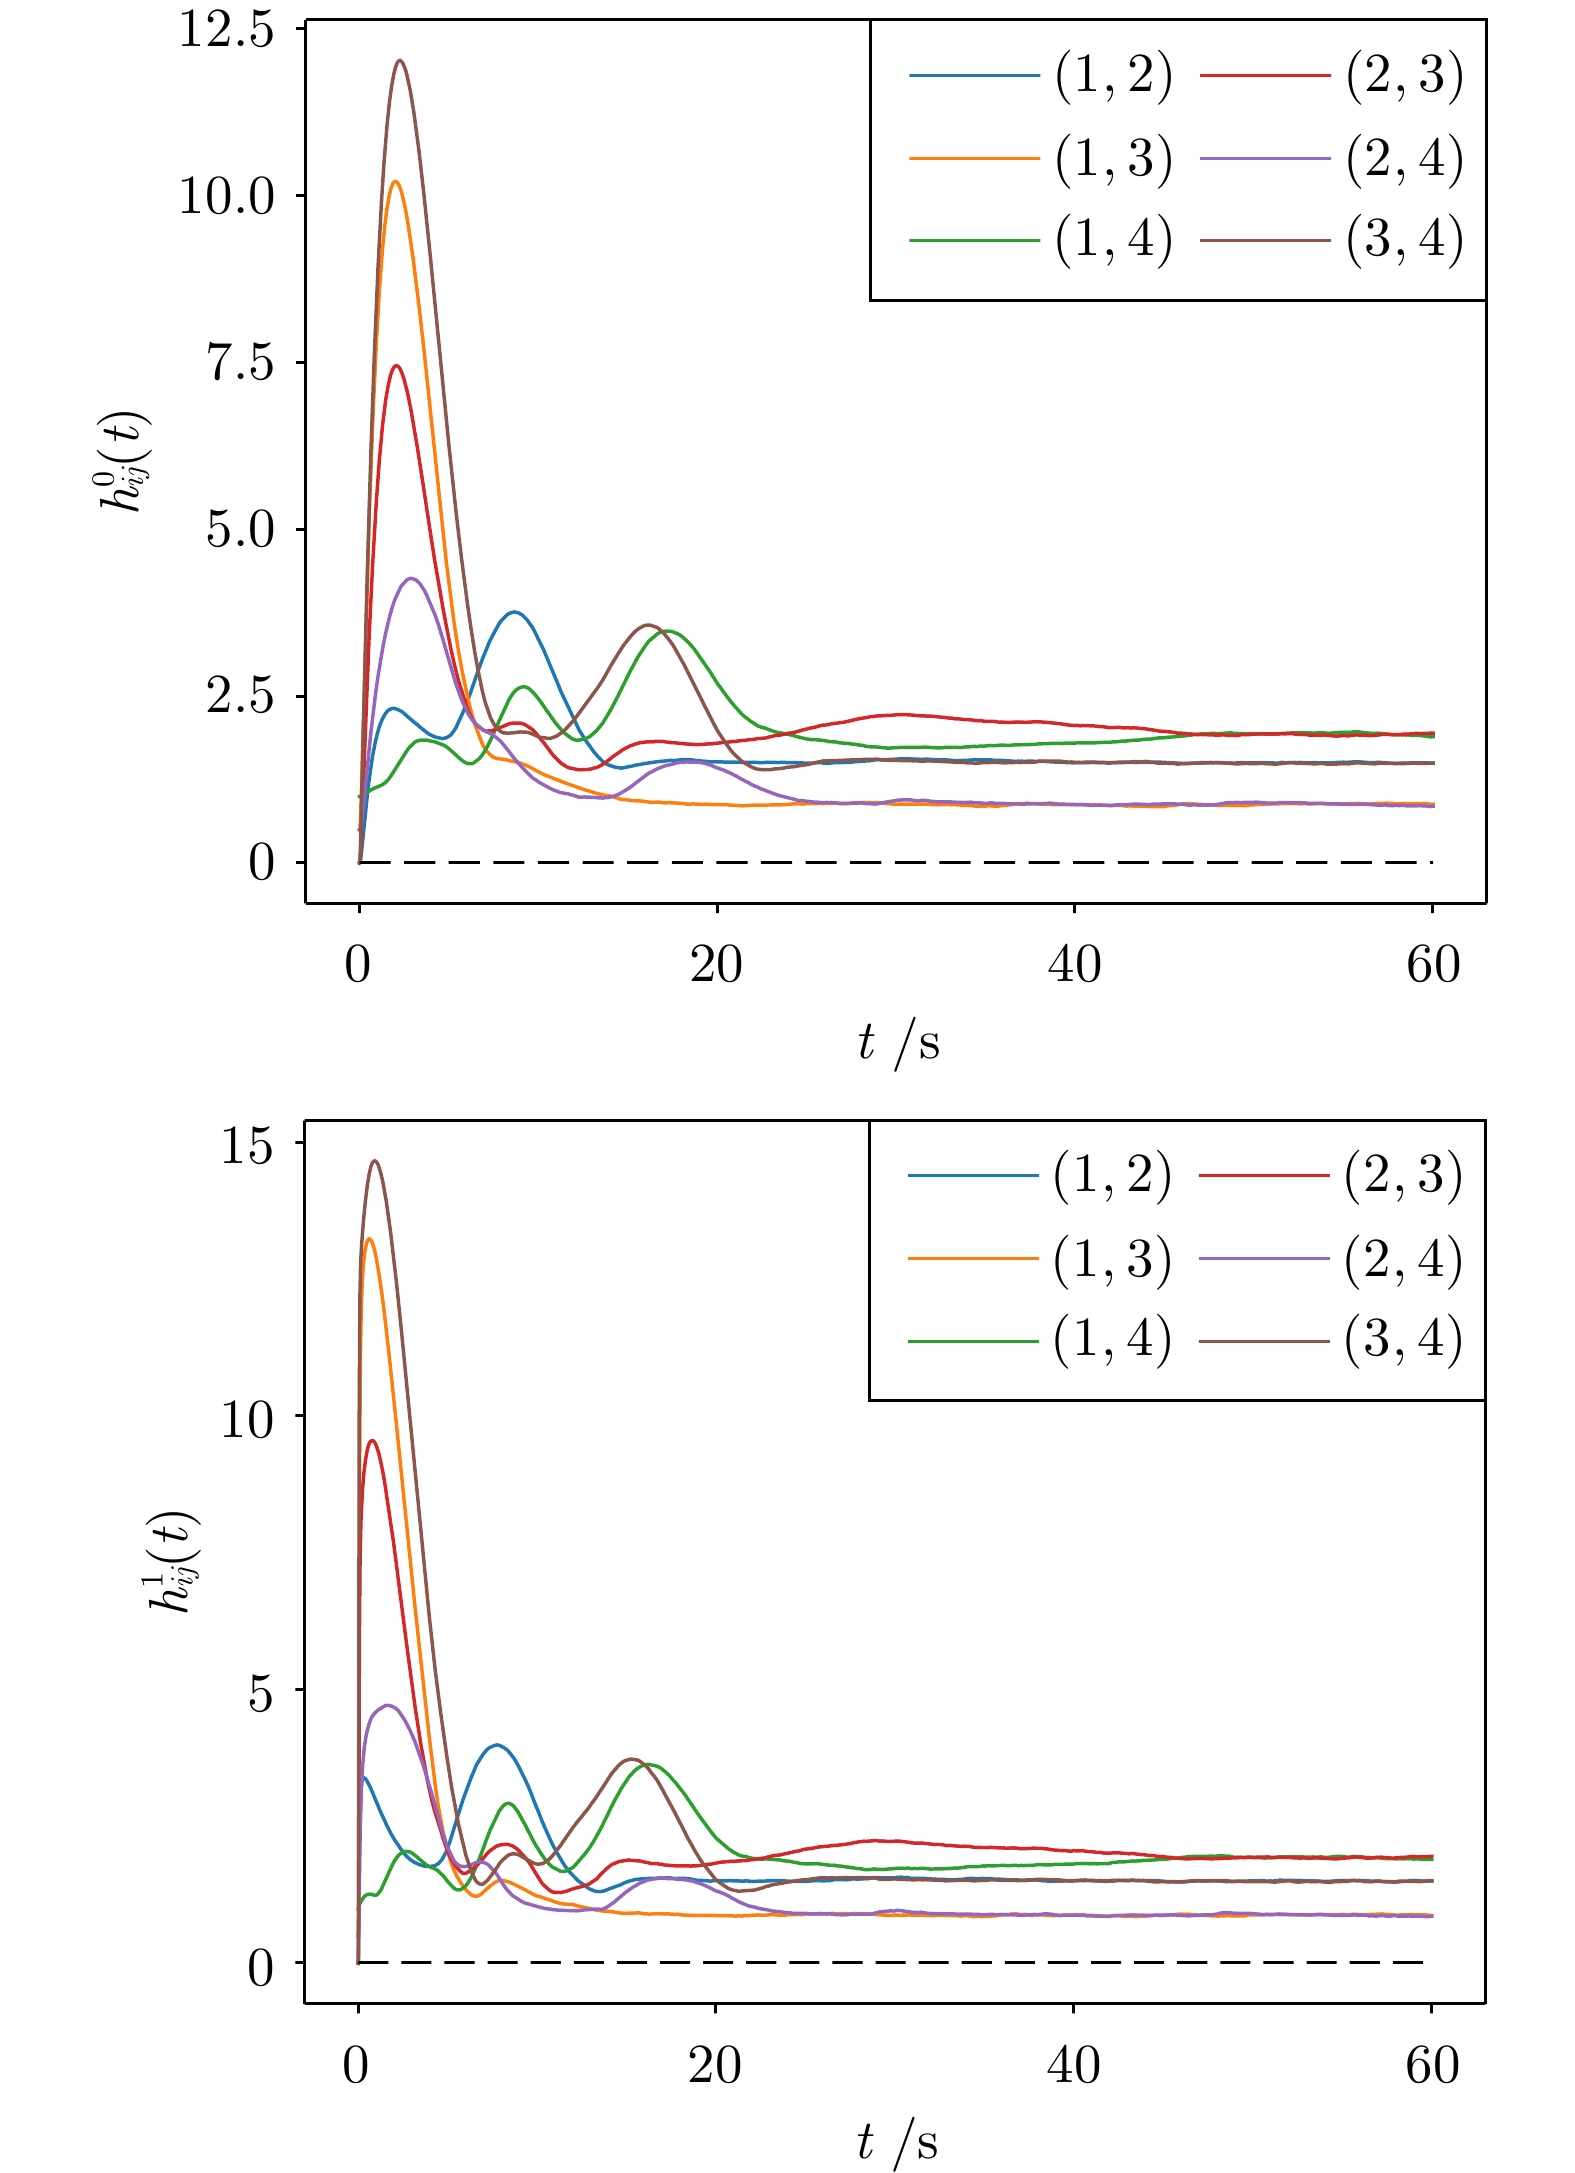
研究多智能体系统的避碰安全控制问题, 目标是在尽量保持标称控制输入的同时, 确保任意智能体对之间始终保持安全距离. 针对二阶系统中安全约束函数相对度为2、传统控制障碍函数难以直接施加控制约束的问题, 引入高阶控制障碍函数框架构造碰撞避免条件, 并将其转化为最小侵入的二次规划控制器. 进一步, 利用安全约束项的对称性, 将原本耦合的不等式约束分解为各智能体可独立求解的线性约束. 在此基础上, 将所提方法推广至含有不确定项的多智能体系统, 设计鲁棒控制障碍函数及构建可实现的鲁棒控制器, 并证明了系统安全集的前向不变性. 数值仿真结果表明, 所提方法可使得系统保持安全性并维持良好的跟踪性能.
研究多智能体系统的避碰安全控制问题, 目标是在尽量保持标称控制输入的同时, 确保任意智能体对之间始终保持安全距离. 针对二阶系统中安全约束函数相对度为2、传统控制障碍函数难以直接施加控制约束的问题, 引入高阶控制障碍函数框架构造碰撞避免条件, 并将其转化为最小侵入的二次规划控制器. 进一步, 利用安全约束项的对称性, 将原本耦合的不等式约束分解为各智能体可独立求解的线性约束. 在此基础上, 将所提方法推广至含有不确定项的多智能体系统, 设计鲁棒控制障碍函数及构建可实现的鲁棒控制器, 并证明了系统安全集的前向不变性. 数值仿真结果表明, 所提方法可使得系统保持安全性并维持良好的跟踪性能.
2026, 52(10): 2307-2317.
doi: 10.16383/j.aas.c260090
cstr: 32138.14.j.aas.c260090
摘要:
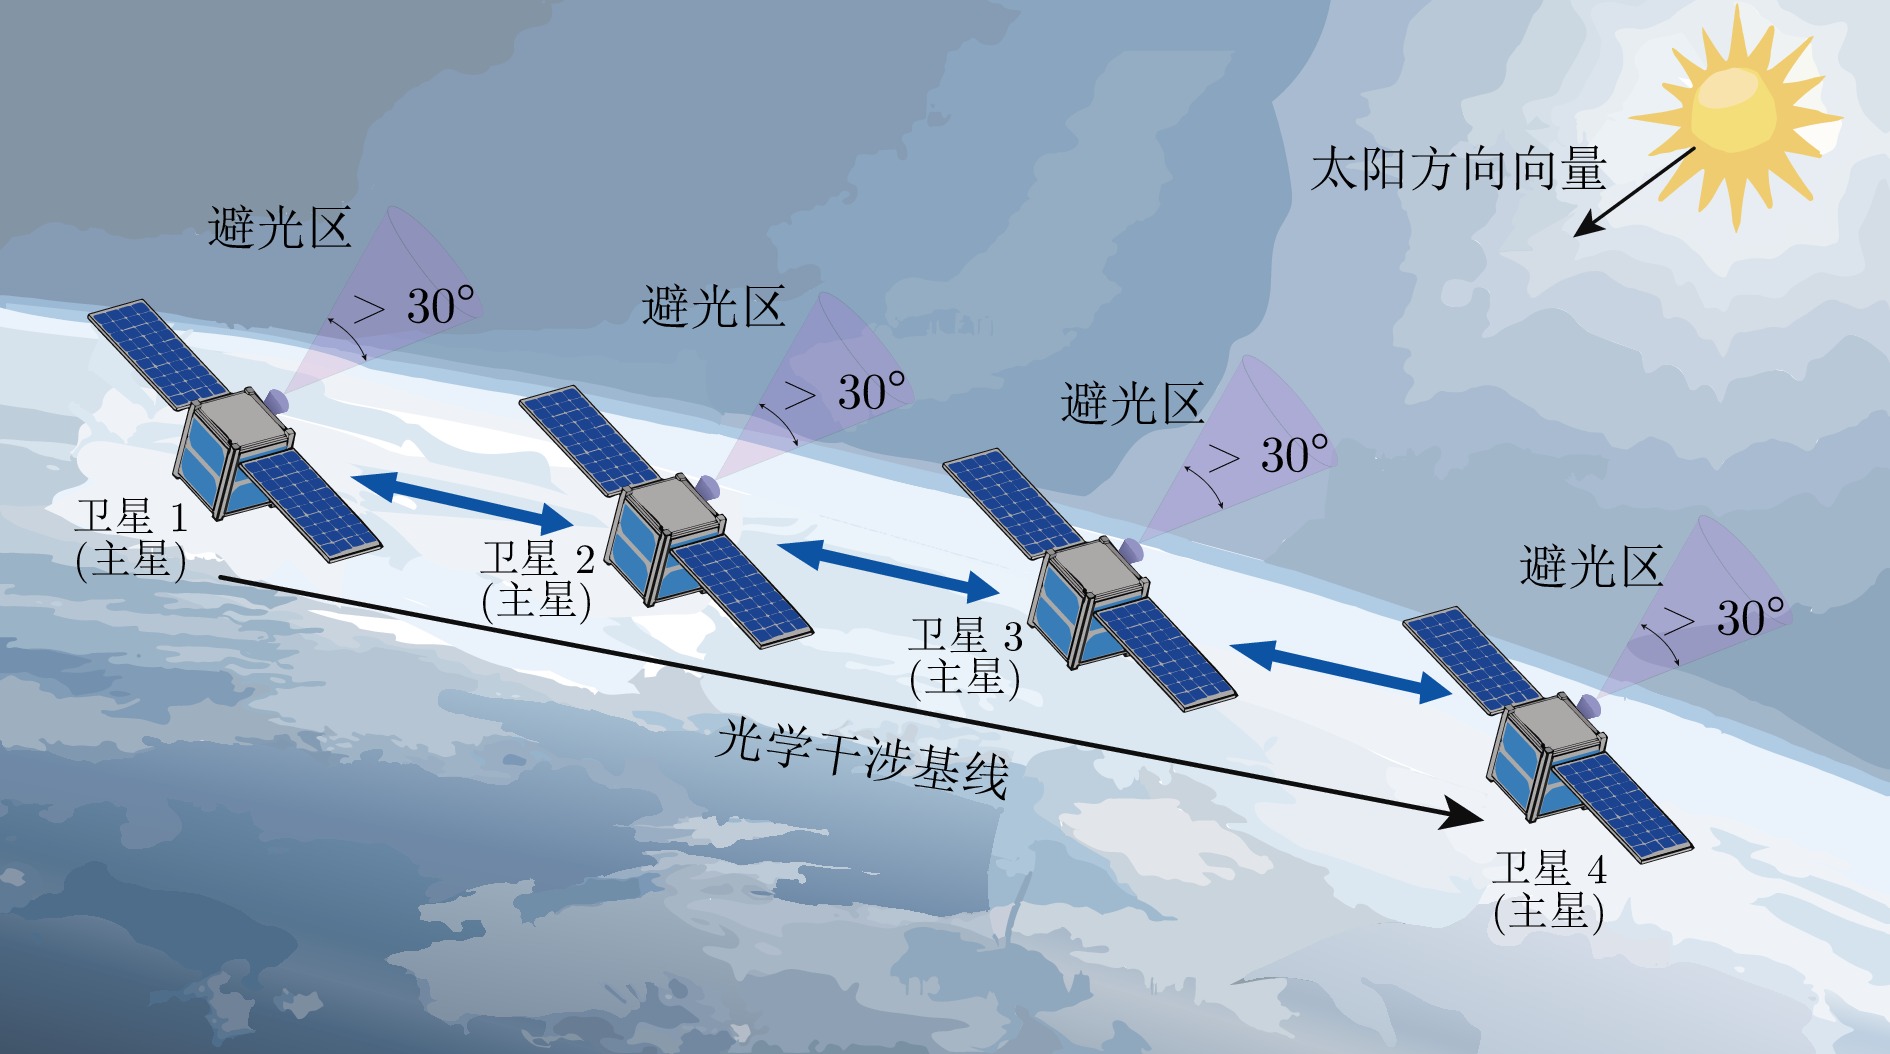
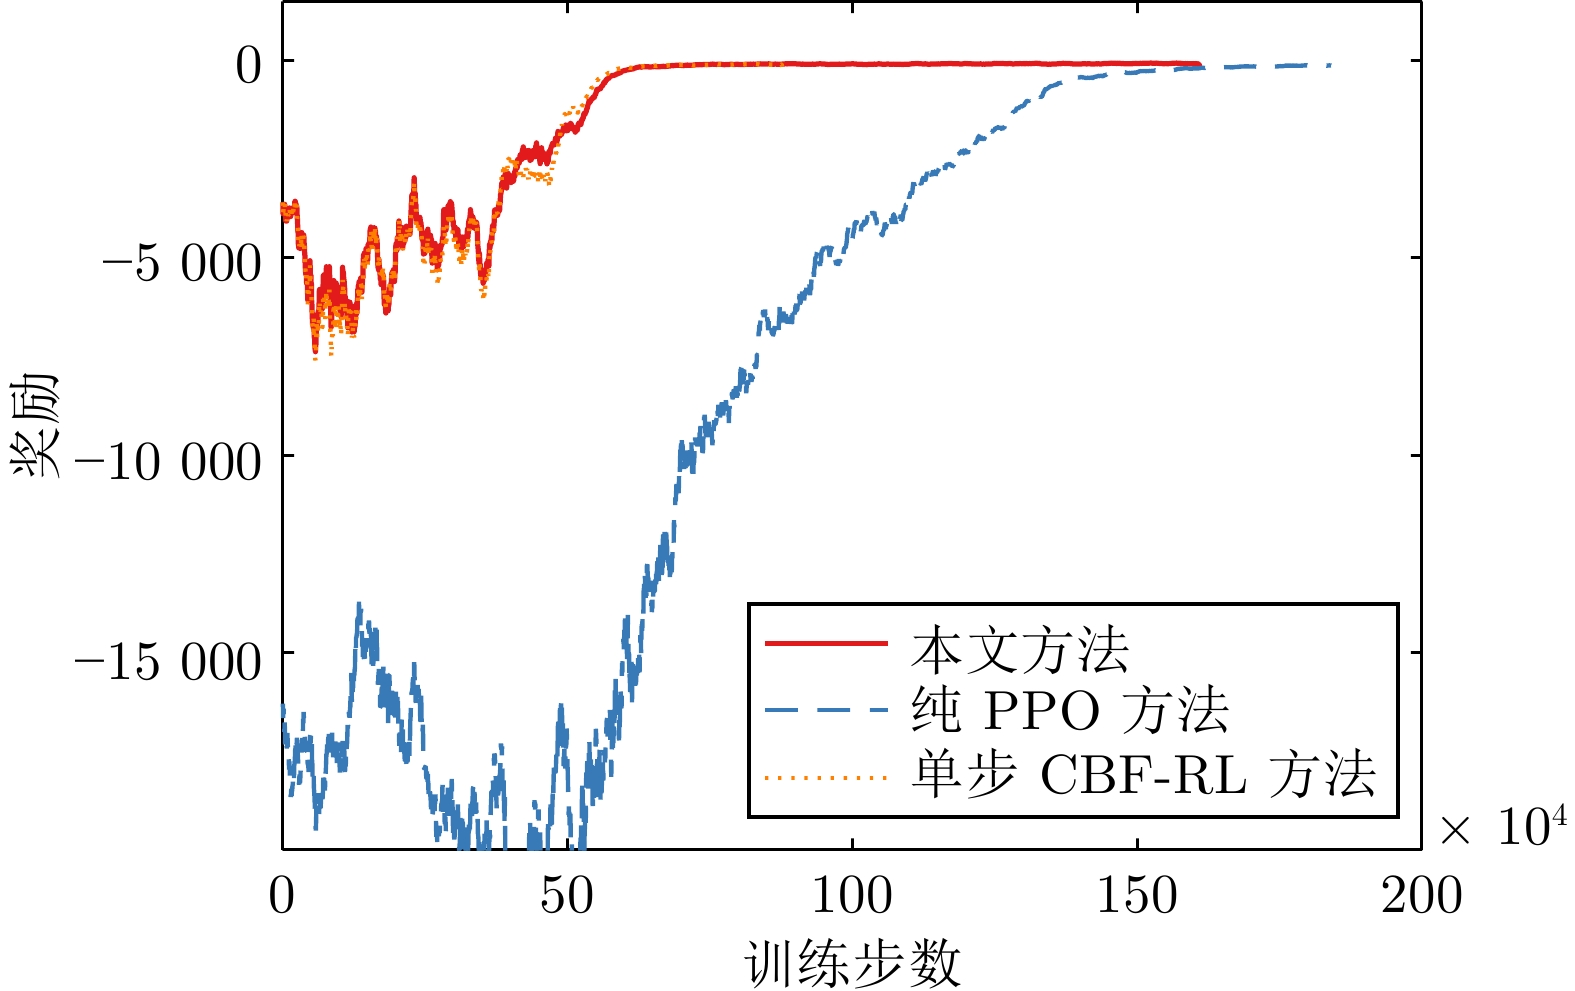
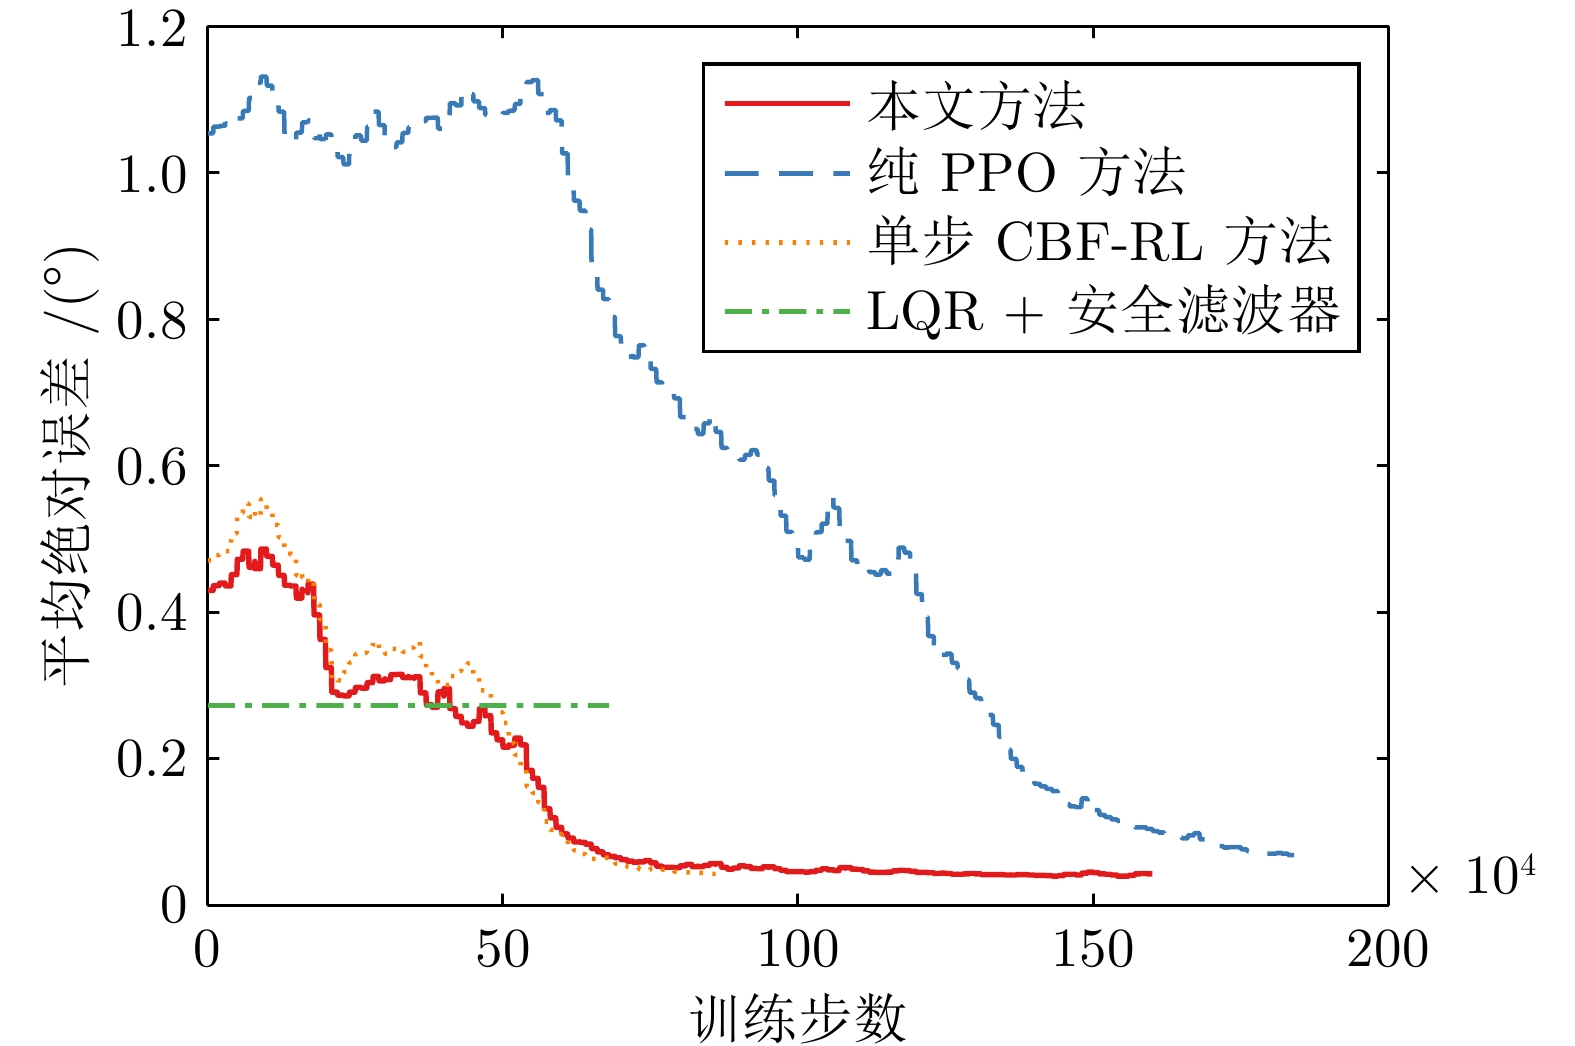
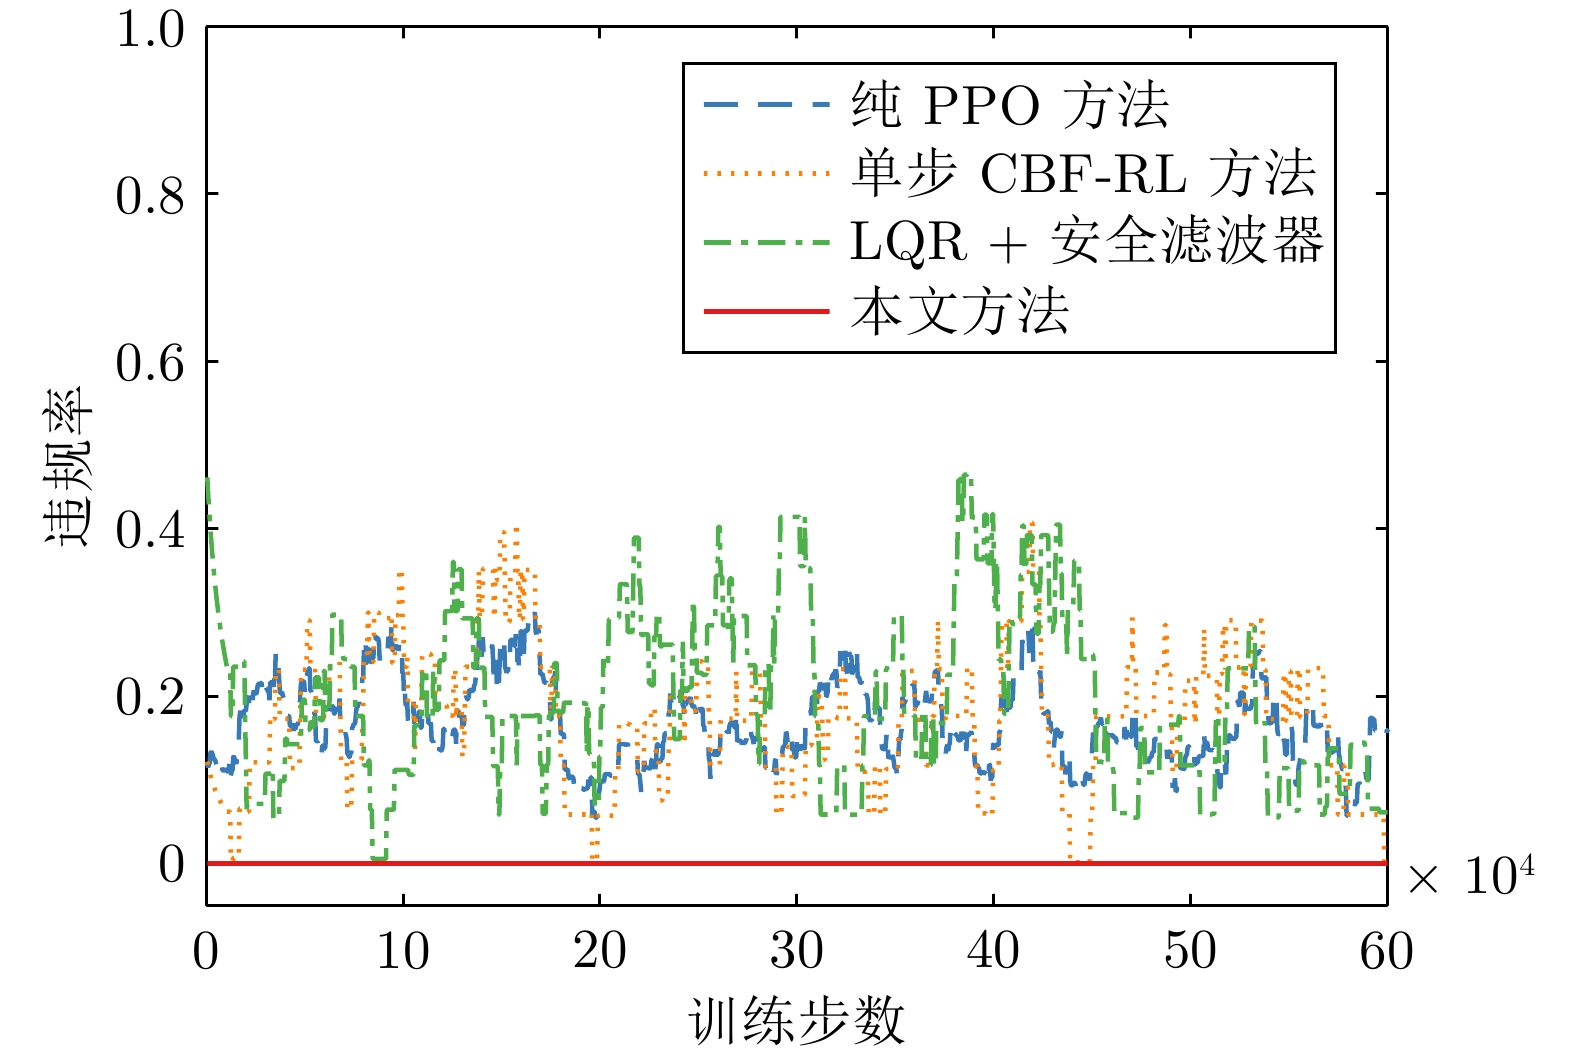
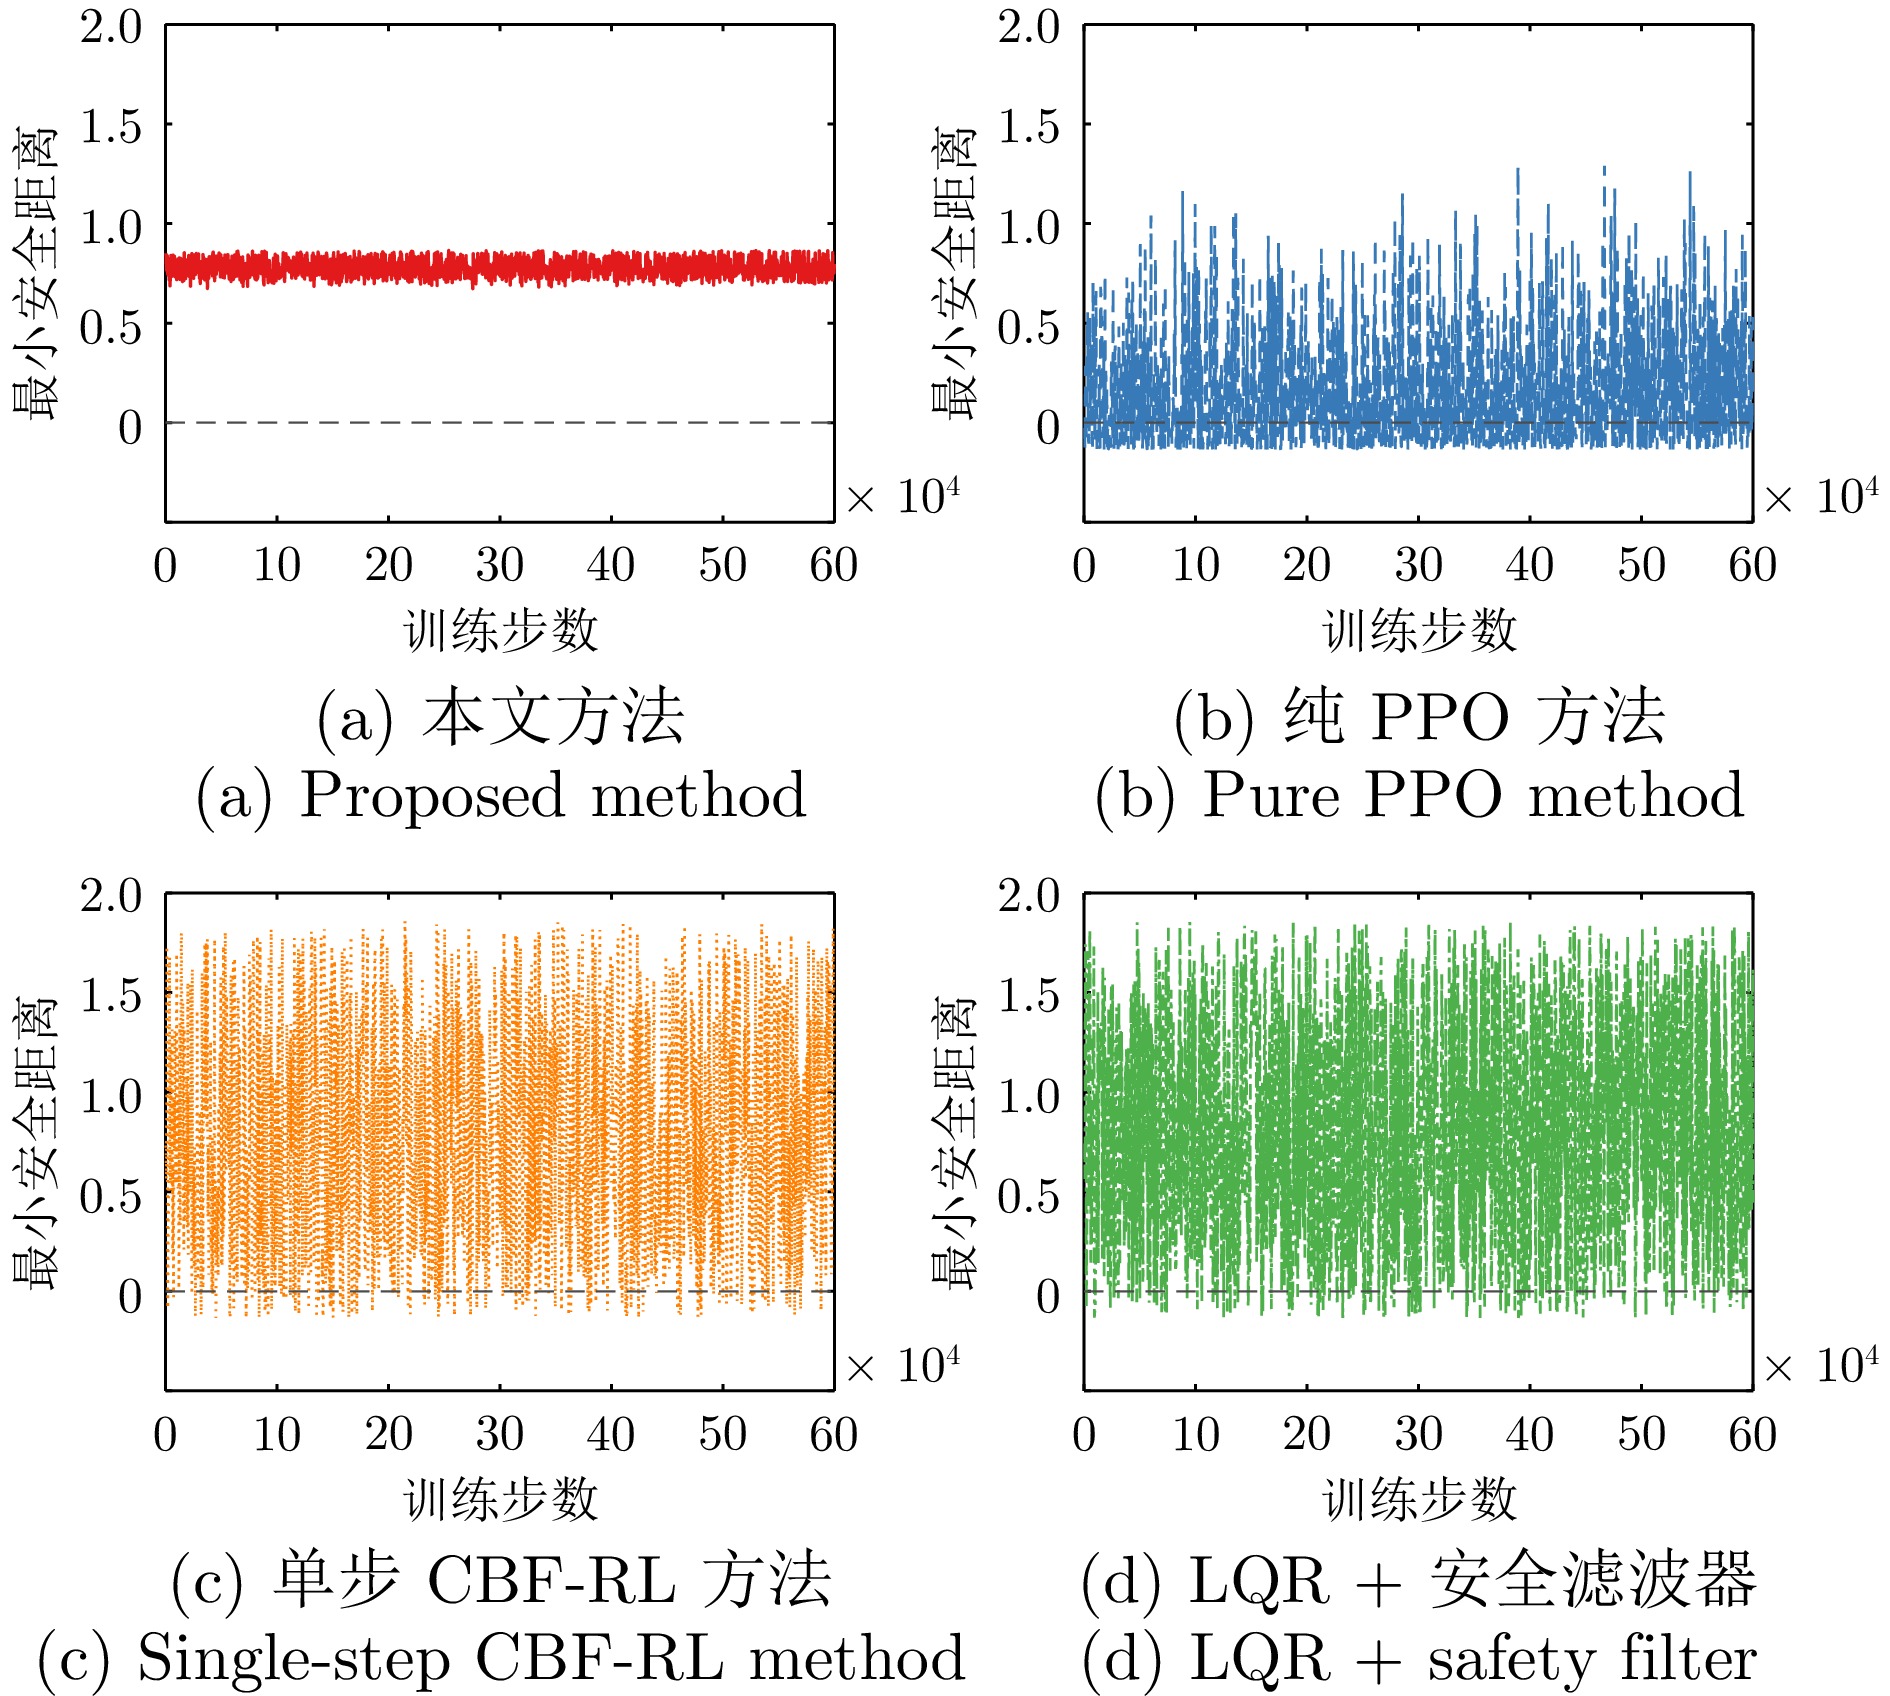
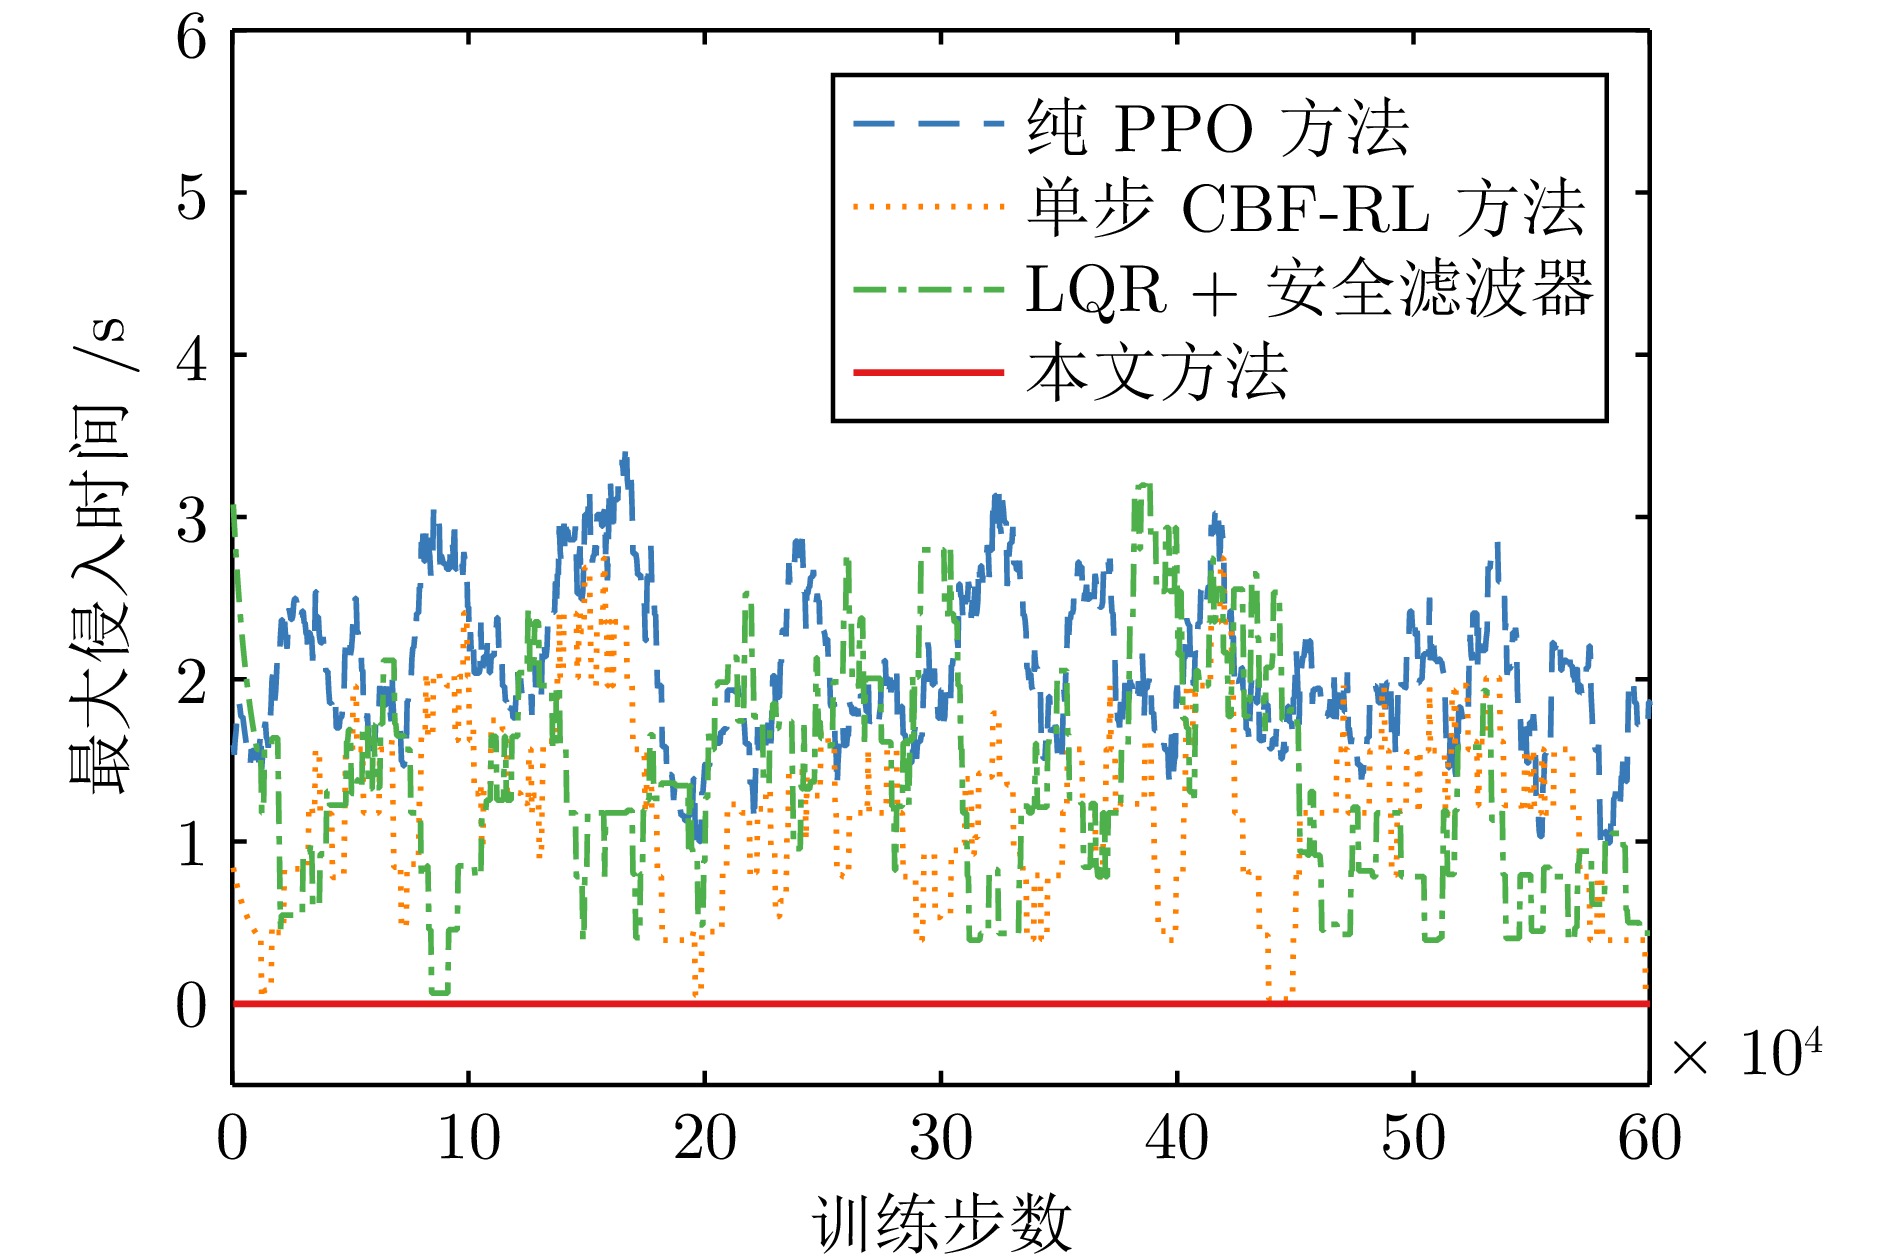
针对存在模型不确定性与外部扰动的多智能体协同控制问题, 提出一种基于模型相对阶解耦的安全强化学习框架. 首先, 利用非线性系统中的相对阶理论, 将高阶状态安全约束映射为输入显式出现的仿射不等式; 在凸多面体参数不确定与有界扰动条件下, 进一步给出由有限个线性不等式交集表征的可认证凸安全动作集, 为在线投影与约束求解提供显式可行域. 其次, 为解决单步屏蔽易产生后继不可行的问题, 设计带终端集的滚动安全滤波器: 在每个时刻维护有限时域备份控制序列, 并通过末端约束与终端控制器保证递归可行性与无限时域安全性. 最后, 利用相对阶标准型构建策略分解架构, 以LQR标称控制器提供稳定热启动, 强化学习仅负责对未建模动态进行补偿, 并采用参数共享的独立近端策略优化算法学习补偿量. 卫星编队姿态控制的仿真结果表明: 在执行器效率不确定与扰动条件下, 所提方法能够将约束违规率维持在接近零的水平, 同时实现更快的训练收敛与更低的跟踪误差.
针对存在模型不确定性与外部扰动的多智能体协同控制问题, 提出一种基于模型相对阶解耦的安全强化学习框架. 首先, 利用非线性系统中的相对阶理论, 将高阶状态安全约束映射为输入显式出现的仿射不等式; 在凸多面体参数不确定与有界扰动条件下, 进一步给出由有限个线性不等式交集表征的可认证凸安全动作集, 为在线投影与约束求解提供显式可行域. 其次, 为解决单步屏蔽易产生后继不可行的问题, 设计带终端集的滚动安全滤波器: 在每个时刻维护有限时域备份控制序列, 并通过末端约束与终端控制器保证递归可行性与无限时域安全性. 最后, 利用相对阶标准型构建策略分解架构, 以LQR标称控制器提供稳定热启动, 强化学习仅负责对未建模动态进行补偿, 并采用参数共享的独立近端策略优化算法学习补偿量. 卫星编队姿态控制的仿真结果表明: 在执行器效率不确定与扰动条件下, 所提方法能够将约束违规率维持在接近零的水平, 同时实现更快的训练收敛与更低的跟踪误差.
2026, 52(10): 2318-2331.
doi: 10.16383/j.aas.c250738
cstr: 32138.14.j.aas.c250738
摘要:
本文研究了隐私保护和不确定马尔科夫切换拓扑下多智能体系统(MASs)的安全协同控制问题. 首先, 采用更具一般性的马尔科夫过程描述多智能体系统的网络拓扑结构, 考虑转移率矩阵包含不确定与部分未知元素的情况; 其次, 为抵御隐私窃听者对状态信息的窃取, 设计保护时长可根据实际需求灵活调整的隐私保护机制; 进而, 考虑系统存在执行器故障与随机发生的虚假数据注入攻击的场景, 通过综合利用估计状态信息与历史触发信息, 设计基于动态记忆事件触发的神经网络自适应控制策略; 最后, 通过仿真模拟对所提理论的有效性进行验证.
本文研究了隐私保护和不确定马尔科夫切换拓扑下多智能体系统(MASs)的安全协同控制问题. 首先, 采用更具一般性的马尔科夫过程描述多智能体系统的网络拓扑结构, 考虑转移率矩阵包含不确定与部分未知元素的情况; 其次, 为抵御隐私窃听者对状态信息的窃取, 设计保护时长可根据实际需求灵活调整的隐私保护机制; 进而, 考虑系统存在执行器故障与随机发生的虚假数据注入攻击的场景, 通过综合利用估计状态信息与历史触发信息, 设计基于动态记忆事件触发的神经网络自适应控制策略; 最后, 通过仿真模拟对所提理论的有效性进行验证.


2026, 52(10): 2332-2340.
doi: 10.16383/j.aas.c260084
cstr: 32138.14.j.aas.c260084
摘要:
神经网络在具身智能领域发挥了重要作用, 而其动态特性控制是其应用的关键. 首先, 针对欺骗攻击和切换拓扑给多具空间动态特性神经网络控制带来的挑战, 提出一种新的分布式事件触发跟踪同步控制协议. 在此基础上, 通过构造新的Lyapunov函数和结合不等式技术, 得到多反应扩散神经网络系统在欺骗攻击和切换拓扑下的事件触发跟踪同步控制条件. 其次, 通过证明任意相邻事件的触发间隔存在正的下界, 排除了系统中的芝诺现象. 同时, 给出系统在无攻击时的事件触发跟踪同步控制条件. 此外, 控制器参数由本文得出的结论来确定, 进一步加强了系统的安全性. 最后, 给出一个数值仿真验证本文所设计控制策略的有效性.
神经网络在具身智能领域发挥了重要作用, 而其动态特性控制是其应用的关键. 首先, 针对欺骗攻击和切换拓扑给多具空间动态特性神经网络控制带来的挑战, 提出一种新的分布式事件触发跟踪同步控制协议. 在此基础上, 通过构造新的Lyapunov函数和结合不等式技术, 得到多反应扩散神经网络系统在欺骗攻击和切换拓扑下的事件触发跟踪同步控制条件. 其次, 通过证明任意相邻事件的触发间隔存在正的下界, 排除了系统中的芝诺现象. 同时, 给出系统在无攻击时的事件触发跟踪同步控制条件. 此外, 控制器参数由本文得出的结论来确定, 进一步加强了系统的安全性. 最后, 给出一个数值仿真验证本文所设计控制策略的有效性.


2026, 52(10): 2341-2352.
doi: 10.16383/j.aas.c260061
cstr: 32138.14.j.aas.c260061
摘要:
针对复杂无人机群易受通信干扰与节点摧毁影响的问题, 研究资源受限条件下的关键节点识别与攻击策略. 首先构建无人机群图模型, 模拟覆盖多种拓扑与运行状态的数据集, 并基于连通性与任务性能变化形成任务退化导向标注; 其次在拓扑先验与任务状态增强Transformer框架下融合拓扑先验与任务状态信息, 提出关键节点评估模型, 并采用加权回归损失提升预测精度; 最后在攻击节点数量与总攻击成本双约束下, 设计基于学习型关键性评分的贪心攻击策略, 并与度中心性、介数中心性及传统图注意力网络策略进行对比. 结果表明, 所提方法在关键性预测与单位资源破坏效能方面优于对比方法, 可为无人机群抗毁性评估与拓扑加固提供参考.
针对复杂无人机群易受通信干扰与节点摧毁影响的问题, 研究资源受限条件下的关键节点识别与攻击策略. 首先构建无人机群图模型, 模拟覆盖多种拓扑与运行状态的数据集, 并基于连通性与任务性能变化形成任务退化导向标注; 其次在拓扑先验与任务状态增强Transformer框架下融合拓扑先验与任务状态信息, 提出关键节点评估模型, 并采用加权回归损失提升预测精度; 最后在攻击节点数量与总攻击成本双约束下, 设计基于学习型关键性评分的贪心攻击策略, 并与度中心性、介数中心性及传统图注意力网络策略进行对比. 结果表明, 所提方法在关键性预测与单位资源破坏效能方面优于对比方法, 可为无人机群抗毁性评估与拓扑加固提供参考.